
项目预览
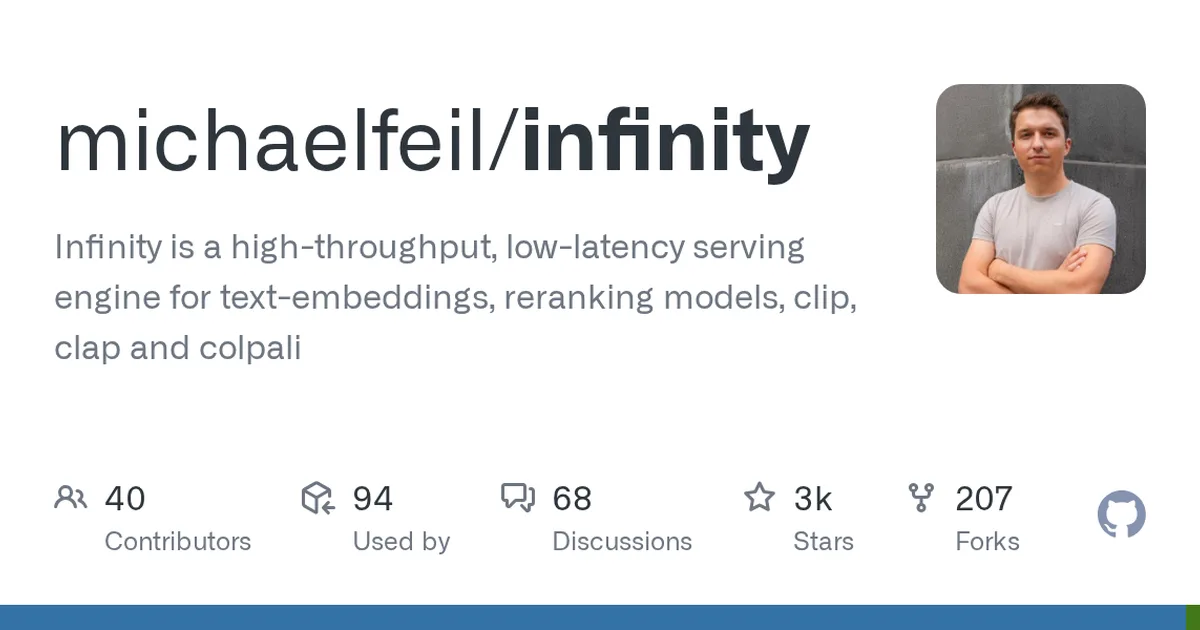
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-08-09 · 当前星标 ★ 2984
技术标签
使用教程
环境要求
- 可用的 Python 环境与虚拟环境(pip 方式安装需要)
- Docker 方式需安装 nvidia-docker,并能用 --gpus all 挂载加速器
- 需要能访问 HuggingFace 下载模型权重
- ROCm 镜像需本机已正确安装 ROCm 并支持 Docker
安装与启动步骤
-
1安装 Infinity CLI
在已激活的虚拟环境中用 pip 安装,[all] 会带上全部推理后端依赖。
pip install infinity-emb[all] -
2启动推理服务
用 v2 子命令启动 REST API,--model-id 指定 HuggingFace 模型,可重复传入多个模型。
infinity_emb v2 --model-id BAAI/bge-small-en-v1.5 -
3查看全部参数
列出 v2 支持的所有命令行参数与说明,便于按需调整端口、引擎等配置。
infinity_emb v2 --help -
4Docker 启动(推荐)
用官方镜像运行,需 --gpus all 挂载加速器,模型缓存挂载到容器内 /app/.cache。
port=7997 model1=michaelfeil/bge-small-en-v1.5 model2=mixedbread-ai/mxbai-rerank-xsmall-v1 volume=$PWD/data docker run -it --gpus all \ -v $volume:/app/.cache \ -p $port:$port \ michaelf34/infinity:latest \ v2 \ --model-id $model1 \ --model-id $model2 \ --port $port -
5CPU 镜像启动
没有 GPU 时改用 latest-cpu 镜像,README 建议优先使用 optimum 引擎。
docker run -it \ -v $volume:/app/.cache \ -p $port:$port \ michaelf34/infinity:latest-cpu \ v2 \ --engine optimum \ --model-id $model1 \ --model-id $model2 \ --port $port -
6挂载本地模型
把本地已有的模型目录挂载进容器,再在 --model-id 里传容器内的路径。
git lfs install cd /tmp mkdir models && cd models && git clone https://huggingface.co/BAAI/bge-small-en-v1.5 docker run -it -v /tmp/models:/models -p 8081:8081 michaelf34/infinity:latest v2 --model-id "/models/bge-small-en-v1.5" --port 8081 -
7安装 Python 客户端
需要在本地代码中调用远程 Infinity 实例时,安装官方生成的 RestAPI 客户端包。
pip install infinity_client
关键配置
| 配置项 | 必填 | 说明 | 示例 |
|---|---|---|---|
--model-id | 是 | 指定部署的模型,可重复传入以同时部署多个模型 | BAAI/bge-small-en-v1.5 |
--port | 否 | REST API 监听端口 | 7997 |
--engine | 否 | 推理引擎,可选 torch / optimum / ctranslate2 | optimum |
--api-key | 否 | 为 API 设置访问密钥 | secret123 |
INFINITY_MODEL_ID | 否 | 用环境变量指定模型,多个模型以分号分隔 | model/id1;model/id2; |
INFINITY_ANONYMOUS_USAGE_STATS | 否 | 设为 0 关闭匿名使用统计上报 | 0 |
如何确认成功
CLI 启动无报错,并监听你设置的 --port 端口(示例 7997),容器日志正常输出即为成功。
常见问题
Q:没有 NVIDIA GPU 怎么部署?
A:改用 latest-cpu(或 x.x.x-cpu)镜像,README 建议优先搭配 --engine optimum 引擎运行。
Q:如何一次部署多个模型?
A:重复传 --model-id 即可,如 v2 --model-id a --model-id b;也可用 INFINITY_MODEL_ID="model/id1;model/id2;"。
Q:如何给 API 加访问密钥?
A:CLI 加 --api-key secret123,或设置环境变量 INFINITY_API_KEY="secret123"。
Q:怎么选择最快的引擎?
A:torch 需模型兼容 sentence-transformers/AutoModel;optimum 需有 onnx 文件(推荐 Xenova 模型);ctranslate2 仅支持 BERT。
Q:如何关闭遥测?
A:执行 export INFINITY_ANONYMOUS_USAGE_STATS="0" 即可关闭匿名使用统计。
注意事项
- Docker 运行时务必挂载加速器(--gpus all);容器内缓存路径由环境变量 HF_HOME 控制,示例挂载到 /app/.cache。
- latest-rocm 与 latest-trt-onnx 镜像未通过 CI/CD 构建、体积较大,建议固定到具体版本号使用。
- LL 参数均有等价环境变量,格式为 INFINITY_{UPPER_CASE_SNAKE_CASE},多值用分号分隔。
- 使用 --engine ctranslate2 时仅支持 BERT 类模型。
核心亮点
- 采用先进批处理和内核优化,吞吐量比同类引擎提升数倍
- 原生支持 CLIP、CLAP、ColPali 等多模态模型,覆盖文本、图像、音视频场景
- 提供 OpenAI 兼容 API,迁移成本低,部署运维简单
不足之处
- 文档和社区生态仍在成长,部分高级功能示例不足
- 对非 NVIDIA GPU 的支持和优化有待完善
适用场景
- 大规模向量检索系统的高性能 embedding 服务
- RAG 应用中的文档重排序与多模态检索
- 实时推荐和语义搜索场景下的低延迟推理
替代项目
TEI (Hugging Face Text Embeddings Inference)、ONNX Runtime、Triton Inference Server
上一篇:WindsurfAPI
下一篇:OM1
同类项目推荐
 m365-copilot-proxy
开源
把已有 M365 Copilot 授权变成 OpenAI 兼容接口
OpenAI-compatible proxy for Microsoft 365 Copilot — use the Copilot licence you alr···
 awesome-mlops
开源
一站式查遍 MLOps 工具,选型不再愁
A curated list of references for MLOps
 new-api-docs-v1
开源
看 New API 文档,快速上手集成,少走弯路。
New API v1 official website documentation
 wirken
开源
给企业智能体装上安全闸门,身份、审计、隔离一步到位
The enterprise gateway for autonomous agents. Identity management, per-channel isola···
 merlin
开源
在 Kubernetes 上轻松管理、部署和上线 ML 模型,省心省力。
Kubernetes-friendly ML model management, deployment, and serving.
 metaflow-tools
开源
一键部署 Metaflow 生产环境,省心运维工作流平台
Tools and utilities for operating Metaflow in production
 pipeshub-ai
开源
统一企业数据,让 AI 搜索和智能体更懂业务
The open-source context layer for AI agents. PipesHub turns your company's knowledge···
 sig-mlops
开源
看这一份MLOps标准指南,少走弯路
CDF SIG MLOps
 babylog
开源
生产环境轻量记录图像和预测,快速排查模型问题
A lightweight logger for machine learning teams to log images and predictions in pro···