

项目预览
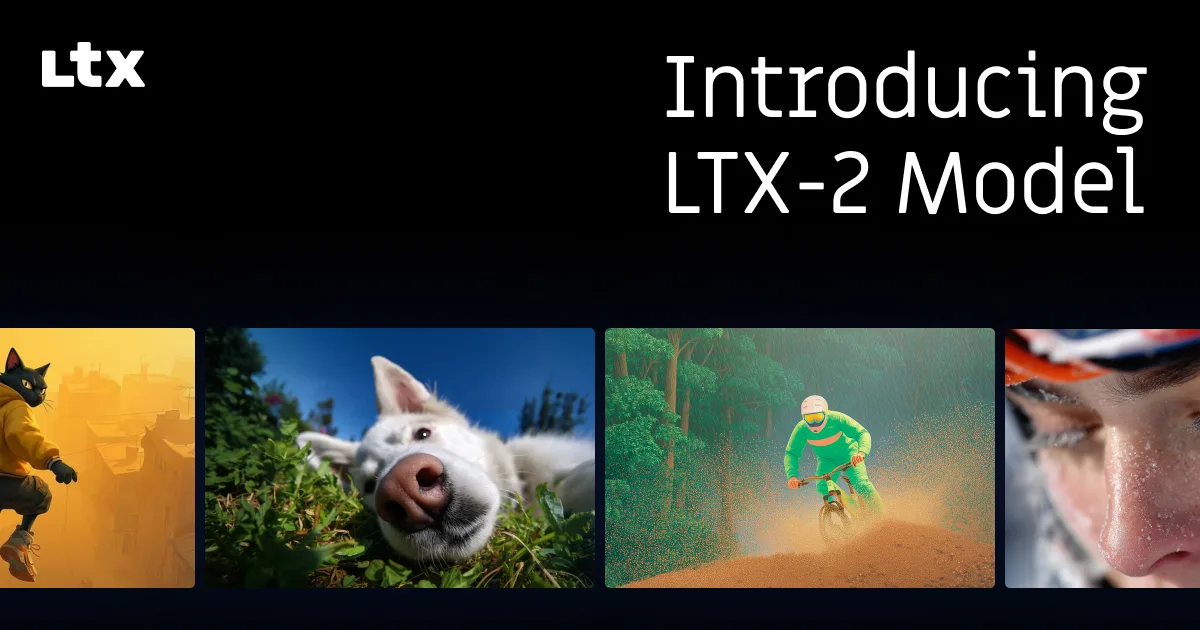
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-08-09 · 当前星标 ★ 4259
使用教程
ℹ 本教程由 AI 依据该项目 README 整理,个别步骤可能需要按你的环境微调。
环境要求
- 已安装 ComfyUI(可从 https://www.comfy.org/download 下载)
- CUDA 兼容的 GPU,显存 32GB 及以上
- 100GB 以上空闲磁盘空间,用于存放模型和缓存
安装与启动步骤
-
1安装并启动 ComfyUI
先从 ComfyUI 官网下载并安装 ComfyUI,确认能正常打开界面,再继续安装 LTXVideo 节点。
-
2打开节点管理器
在 ComfyUI 界面中点击 Manager 按钮,或直接按快捷键 Ctrl+M 打开管理器面板。
-
3进入自定义节点安装
在管理器中选择 Install Custom Nodes 选项,进入自定义节点安装页面。
-
4搜索 LTXVideo
在搜索框中输入 “LTXVideo”,找到对应的 ComfyUI-LTXVideo 插件条目。
-
5点击安装并等待
点击 Install 开始安装,安装过程中保持网络畅通,等待安装完成提示。
-
6重启 ComfyUI
安装完成后重启 ComfyUI,使新增节点生效。
-
7查看示例工作流
插件自带示例工作流,位于 ComfyUI 的 custom_nodes 目录下,可浏览目录选择所需工作流。
ls ComfyUI/custom_nodes/ComfyUI-LTXVideo/example_workflows/
如何确认成功
重启 ComfyUI 后,节点菜单中出现 “LTXVideo” 分类,即表示插件安装成功。
常见问题
Q:安装完成后找不到 LTXVideo 节点怎么办?
A:先确认已重启 ComfyUI;节点会出现在节点菜单的 “LTXVideo” 分类下,若仍没有可检查管理器中的安装是否成功完成。
Q:需要自己手动下载模型吗?
A:不需要。README 说明所需模型会在首次使用时自动下载,请保证网络可用并预留 100GB 以上磁盘空间。
Q:对显卡有什么要求?
A:需要支持 CUDA 的 GPU,且显存为 32GB 或以上,否则可能无法顺利运行 LTX-2 工作流。
Q:示例工作流在哪里找?
A:在 ComfyUI/custom_nodes/ComfyUI-LTXVideo/example_workflows/ 目录中,包含文本/图像生成视频等多种官方示例。
注意事项
- LTX-2 已内置于 ComfyUI 核心,本仓库提供的是扩展节点与工作流。
- 首次使用会自动下载模型,耗时较长且占用磁盘,请提前预留空间。
- 安装方式是直接使用 ComfyUI Manager,无需手动 git clone 或 pip install。
核心亮点
- 官方支持,与 ComfyUI 深度集成,节点化操作直观高效
- 支持文本/图像生成视频及视频扩展,功能全面
- 基于 DiT 架构,生成视频质量高,社区反馈积极
不足之处
- 依赖 ComfyUI 环境,需额外安装配置
- 文档/社区待观察
适用场景
- 创意短视频快速生成
- 图像动画化与动态海报制作
- 视频内容扩展与续写
替代项目
ComfyUI-AnimateDiff-Evolved、ComfyUI-VideoHelperSuite、ComfyUI-CogVideo
上一篇:Bernini
同类项目推荐
 LUMIERE
开源
用文本直接生成连贯视频,复现谷歌时空扩散模型
Implementation of the text to video model LUMIERE from the paper: "A Space-Time Diff···
 Pixelle-Video
开源
丢个创意进去,脚本画面剪辑全自动出片,省掉整个剪辑团队。
AI 全自动短视频引擎 | AI Fully Automated Short Video Engine
 VisionCrafter
开源
一句话生成图片、动画和配乐,让创意动起来
Craft your visions
 Live2Diff
开源
让视频流实时变身,扩散模型逐帧生成不卡顿
Live2Diff: A Pipeline that processes Live video streams by a uni-directional video D···
 UniAnimate-DiT
开源
上传一张图,让照片里的人物动起来,生成自然流畅的动画视频。
UniAnimate-DiT: Human Image Animation with Large-Scale Video Diffusion Transformer
 Echo-Memory
开源
给视频生成装上记忆,让长视频更连贯
Official code for Echo-Memory: a controlled study of memory in action-conditioned vi···
 ASCILINE
开源
把视频实时变成字符画,网页 30 帧流畅播放
A high-performance ASCII video rendering engine featuring real-time WebSocket binary···
 NOVA
开源
扔掉向量量化,自回归直接生成流畅视频
[ICLR 2025] Autoregressive Video Generation without Vector Quantization
 DAWN-pytorch
开源
用扩散模型快速生成动态说话头视频,告别卡顿和误差累积
Offical implement of Dynamic Frame Avatar with Non-autoregressive Diffusion Framewor···