

项目预览
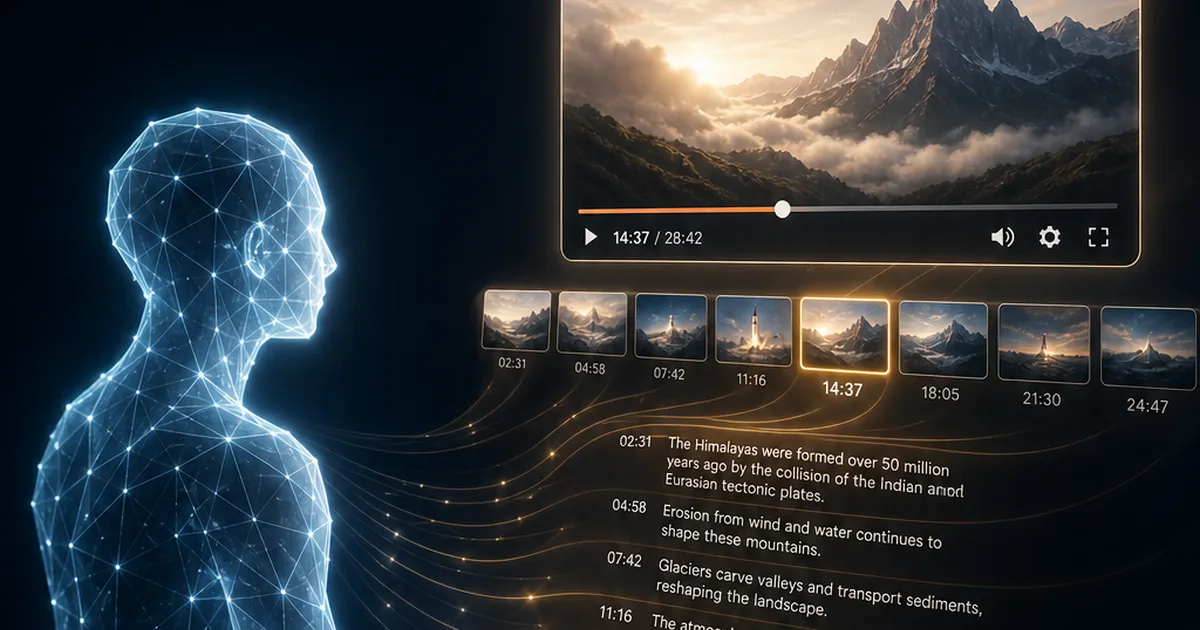
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-08-09 · 当前星标 ★ 2303
技术标签
使用教程
环境要求
- Python 环境(可用 pip 安装包)
- 网络可访问 PyPI 与 GitHub
- 若要在 AI Agent 中使用,需要支持 skills 的宿主(Claude Code、Cursor、Codex、Copilot、Gemini CLI 等)
- 推荐安装带 whisper 附加项的版本,否则没有语音转文字能力
安装与启动步骤
-
1安装视频理解包
用 pip 安装 claude-real-video,推荐加 [whisper] 附加项以获得关键帧、去重和语音转录的完整能力。
pip install "claude-real-video[whisper]" -
2安装 Agent 技能
一条命令把该技能安装进 Claude Code、Cursor、Codex、Copilot、Gemini CLI 等 50 多个 agent 宿主。
npx skills add HUANGCHIHHUNGLeo/claude-real-video -
3接入 Claude Code 插件市场
在 Claude Code 内依次执行两条插件命令;如需要自动更新,可在 /plugin → Marketplaces 中开启。
/plugin marketplace add HUANGCHIHHUNGLeo/claude-real-video /plugin install claude-real-video@claude-real-video -
4用命令行处理视频
只做命令行用途时,不需要任何插件,把视频链接替换进去即可运行 crv。
crv "<url>" -
5让 Agent 看视频
把视频链接粘贴到已装好技能的 agent 中,直接向它提问视频内容。
如何确认成功
把视频链接粘进 agent 并提问,能基于画面与转录回答;或直接运行 crv "<url>" 得到关键帧与转录结果。
常见问题
Q:不加 [whisper] 会怎样?
A:pip 的附加项不会自动安装,不装 [whisper] 就没有语音转文字;只有自带字幕的视频仍能得到转录文本。
Q:必须用 Claude Code 插件吗?
A:不是。只做命令行使用的话,完成 pip 安装后直接用 crv "<url>" 即可,无需插件市场步骤。
Q:crv 和 crv Pro 分别是什么?
A:crv 是 claude-real-video 这个 PyPI 包的简称;crv Pro 是付费附加组件,在 Capafy 上以 llm-real-video Pro 的名称出售。
Q:关键帧会不会太多、太费 token?
A:不会。同一段 58 秒片段按固定 1 fps 会得到 58 帧,crv 只保留真正有差异的 26 帧,配合 --grid 可打包成 3 张联系表,token 更少且不丢内容。
注意事项
- 安装时注意引号,pip install "claude-real-video[whisper]" 才能正确识别附加项。
- README 的安装步骤没有显式要求 ffmpeg,但项目技术栈包含 ffmpeg,视频处理报错时请先检查系统是否已安装。
- 插件市场命令是在 Claude Code 内部执行的斜杠命令,不是终端命令,不要复制到 bash 中运行。
核心亮点
- 场景感知切分,智能去重关键帧,避免冗余信息
- 支持 URL 和本地文件,本地运行保护隐私
- 输出格式适配 LLM,可直接用于 Claude 等模型
不足之处
- 依赖外部转录服务,可能产生额外成本
- 文档/社区待观察
适用场景
- 视频内容摘要与问答
- 视频会议纪要与要点提取
- 视频素材的自动化标注与检索
替代项目
Video-LLaVA、LLaVA-NeXT-Video、VideoPrism
上一篇:LISA
同类项目推荐
 kornia
开源
让图像变换可微,深度学习视觉更灵活
Geometric Computer Vision Library for Spatial AI
 CLIP-API-service
开源
把 CLIP 模型变成一行代码就能调用的 API,快速实现图文搜索与识别。
CLIP as a service - Embed image and sentences, object recognition, visual reasoning,···
 chandra
开源
复杂表格表单手写,一次识别还原版面
OCR model that handles complex tables, forms, handwriting with full layout.
 Awesome_Mamba
开源
一网打尽医学影像中的高效状态空间模型研究
Computation-Efficient Era: A Comprehensive Survey of State Space Models in Medical I···
 PaddleOCRSharp
开源
在 .NET 里离线调用轻量 OCR,小图识别也稳
PaddleOCRSharp是一个.NET的OCR工具本地类库,可离线使用。包含文本识别、文本检测、表格识···
 sparrow
开源
从文档和图片中一键提取结构化数据,驱动自动化流程。
Structured data extraction, instruction calling and agentic workflows with ML, LLM a···
 platypus
开源
用 R 一份配置搞定 2D/3D 医学图像分割
Deep learning for medical images in R: semantic and instance segmentation, object de···
 EmerNeRF
开源
自监督分解动态场景,轻松重建三维世界
PyTorch Implementation of EmerNeRF: Emergent Spatial-Temporal Scene Decomposition vi···
 vietnamese-ocr-toolbox
开源
越南语证件发票图片,一键转成可编辑文字
A toolbox for Vietnamese Optical Character Recognition.