
rapid_llm
用 Triton 手写轻量推理框架,快速读懂并改造 LLM 内核
项目预览
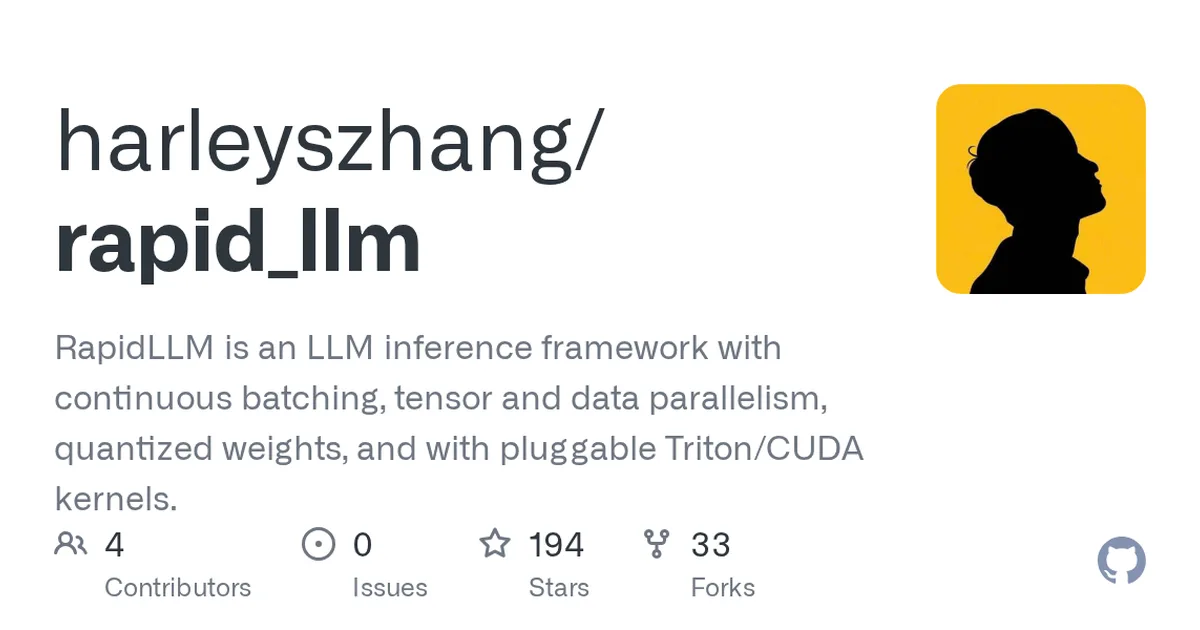
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-09-16 · 当前星标 ★ 196
核心亮点
- 基于 Triton 实现注意力内核,代码量小、可读性高,便于二次开发和教学演示
- 支持连续批处理与 FlashAttention-3,具备现代推理框架的关键调度与加速特性
- 覆盖 LLaMA3、Qwen3-MoE、Qwen3-VL 等较新模型结构,并涉及张量并行与多模态场景
不足之处
- 项目处于早期阶段,星标仅 195,生产环境稳定性与性能调优经验有限
- 文档与社区生态尚不完善,遇到问题可参考的案例和讨论较少
适用场景
- 学习大模型推理系统内部实现,理解注意力内核与调度机制
- 在科研或课程中快速验证新的批处理策略、KV Cache 管理或 Triton 内核优化
- 作为轻量基线,对比 vLLM 等框架在特定模型上的推理性能与实现差异
替代项目
vLLM、SGLang
同类项目推荐
 coze-loop
开源
一站式调试、评估、监控你的 AI Agent,让开发更高效
Next-generation AI Agent Optimization Platform: Cozeloop addresses challenges in AI ···
 rainbond
开源
一键把 AI 项目跑在 Kubernetes 上,自动运维不折腾
Rainbond is an open-source container platform that requires no Kubernetes expertise.···
 tabularis
开源
一个桌面工具,连接 15+ 数据库,还能让 AI 帮你写 SQL。
Open-source desktop SQL workspace with 3 built-in database drivers and 26 shipped dr···
 Free-GPT4-WEB-API
开源
自建免费AI网关,一次接入GPT、Gemini、Claude等模型,无限调用。
Not just GPT4! Easy to use, Self-Hosted, Unlimited and Free WEB API of the latest A.···
 MoE-Infinity
开源
把 MoE 大模型塞进小显存,推理快还省钱
PyTorch library for cost-effective, fast and easy serving of MoE models.
 llm-sandbox
开源
给 LLM 一个安全的代码沙箱,跑 AI 生成的代码不翻车
Lightweight and portable LLM sandbox runtime (code interpreter) Python library.
 nixl
开源
为分布式推理提供统一高速数据传输层
NVIDIA Inference Xfer Library (NIXL)
 brinicle
开源
低内存跑向量检索,小机器也能扛千万级索引
A resource-efficient C++ vector index engine built for low-RAM production workloads
 sie
开源
一个服务搞定所有模型,让智能体部署不再头疼
Open-source inference server and production cluster for all the models your agent ne···