

项目预览
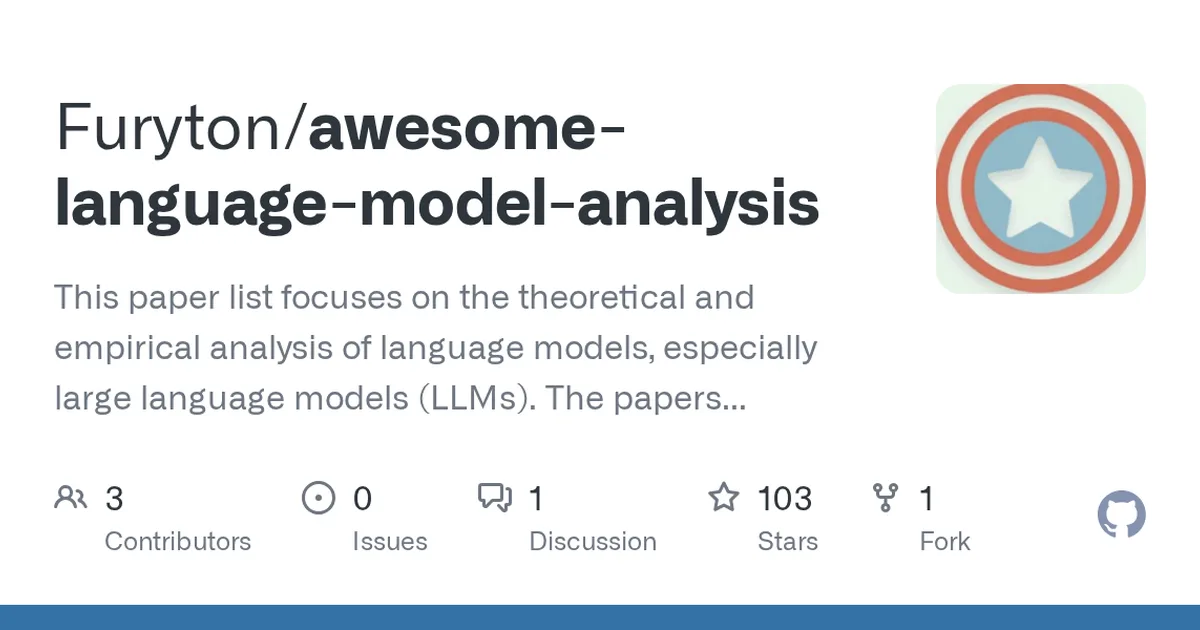
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-08-09 · 当前星标 ★ 103
核心亮点
- 主题聚焦:专门梳理LLM的理论与实证分析论文,而非泛泛的AI资源列表
- 分类清晰:按学习行为、泛化能力等维度组织,便于按需查阅
- 持续更新:依托社区维护,紧跟大模型分析领域的最新研究
不足之处
- 内容覆盖有限:早期项目,论文数量可能不够全面
- 文档/社区待观察:缺乏使用指南或贡献规范,参与门槛不明确
适用场景
- 科研入门:快速了解LLM分析领域的关键论文和方向
- 论文调研:为撰写综述或研究提案收集参考文献
- 技术选型:对比不同模型分析方法的理论基础
替代项目
awesome-llm、awesome-llm-research、llm-analysis-papers
同类项目推荐
 ai-eval-platform
开源
一站式评测 AI 应用,让质量看得见
开源 AI 应用评测平台,支持 RAG、AI Agent、多轮对话、LLM-as-Judge、接口评测、评测报告···
 Jailbreak-Foundry
开源
把越狱论文变成可跑的攻击测试,实时更新基准
A system that turns jailbreak papers into runnable attacks and benchmarks — live, a···
 Awesome-Multimodal-LLM-for-Code
开源
一页看全多模态代码生成论文与数据集
[TMLR 2026] Multimodal Large Language Models for Code Generation under Multimodal Sc···
 SILENTCHAIN
开源
在 Burp 里用大模型辅助找 Web 漏洞
AI-powered vulnerability scanner extension for Burp Suite with multi-provider suppor···
 judgeval
开源
给 AI Agent 装上持续评测仪表盘,让改进有据可依
The Continuous-Improvement Stack for Agents. Our environment data and evals power ag···
 clean-fid
开源
让 FID 分数更可信,生成模型评估不踩坑
PyTorch - FID calculation with proper image resizing and quantization steps [CVPR 20···
 DSG
开源
用场景图细粒度检验文生图,让评估更靠谱
Davidsonian Scene Graph (DSG) for Text-to-Image Evaluation (ICLR 2024)
 ResolveLab
开源
给 Agent 工具注入故障,用副作用打分验真本事
Fault-injected tool environments with side-effect grading for evaluating and post-tr···
 CUREBench
开源
给AI看病决策打分,推动医疗AI更靠谱
CUREBench @ NeurIPS 2025: Benchmarking AI reasoning for therapeutic decision-making ···