
项目预览
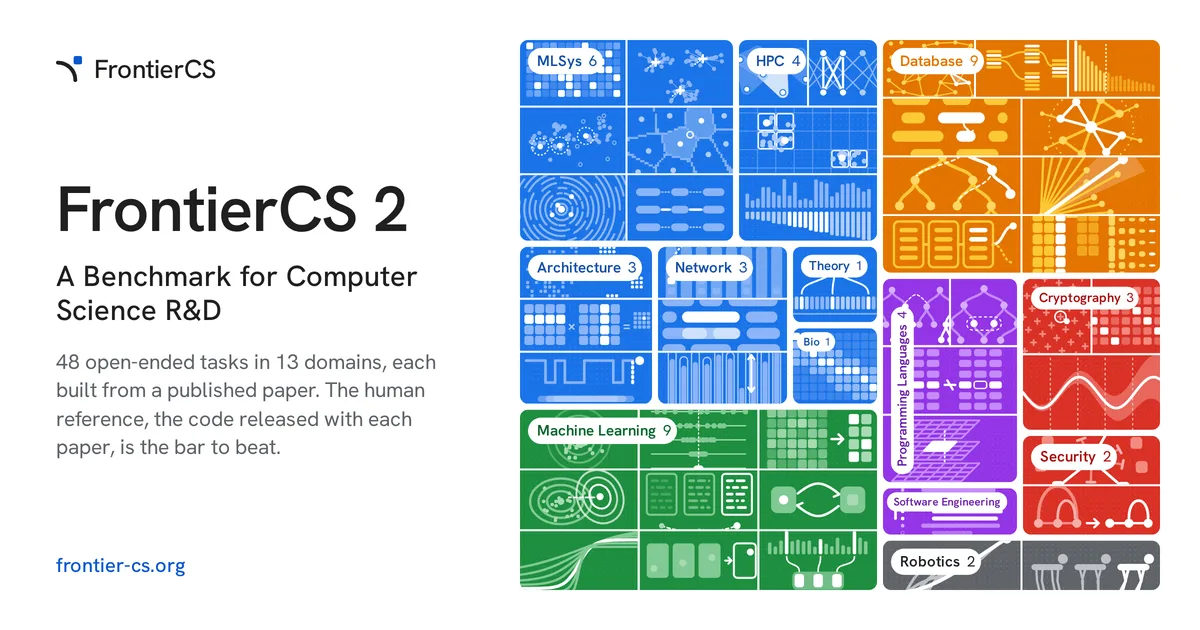
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-10-23 · 当前星标 ★ 335
核心亮点
- 题目为开放式 CS 难题,不依赖固定标准答案,更贴近真实科研与工程问题
- 覆盖系统、算法、理论等多方向,能综合考察长程推理与方案设计能力
- 提供配套评测流程与评分机制,可直接用于横向对比不同模型
不足之处
- 项目处于早期,题目规模与覆盖广度仍有限
- 开放式评分依赖评审模型或人工判断,结果稳定性与可复现性待验证
适用场景
- 模型发布前评估其在开放式 CS 问题上的推理与设计能力
- 研究团队对比不同 LLM 在非标准答案任务上的表现差异
- 作为训练数据筛选或 RL 奖励设计的难题来源
替代项目
SWE-bench、HumanEval
同类项目推荐
 coir
开源
给代码检索模型做全面体检,一张卷子测出真实力。
(ACL 2025 Main) A Comprehensive Benchmark for Code Information Retrieval.
 superbenchmark
开源
一键体检 AI 集群,跑分定位硬件瓶颈
A validation and profiling tool for AI infrastructure
 Awesome-LLM-Red-Teaming
开源
一站式收集 LLM 红队测试资源,快速上手安全攻防
A curated list of awesome LLM Red Teaming training, resources, and tools.
 VibeSearchBench
开源
专治搜索系统'听不懂人话',用200个模糊任务测出真实力
The hardest search benchmark in the wild — vague, multi-turn, proactive. 200 long-h···
 Loong
开源
测出长文本大模型真实力,必须跨文档推理才能答对
[EMNLP 2024 (Oral)] Leave No Document Behind: Benchmarking Long-Context LLMs with Ex···
 memorybench
开源
一套基准跑遍对话记忆与 RAG,选型不再靠拍脑袋
Unified benchmark for evaluating conversational memory and RAG across multiple datas···
 evalstats
开源
小样本评测也能算出模型差异是否真实
Statistical inference for AI evaluations, from model comparisons to corrections for ···
 eval
开源
用真实编码任务测出大模型真实力,结果公开可对比
Public results and task definitions for FrontierHarness Eval
 DS-1000
开源
用真实数据科学题测出大模型写代码的真实水平
[ICML 2023] Data and code release for the paper "DS-1000: A Natural and Reliable Ben···