
项目预览
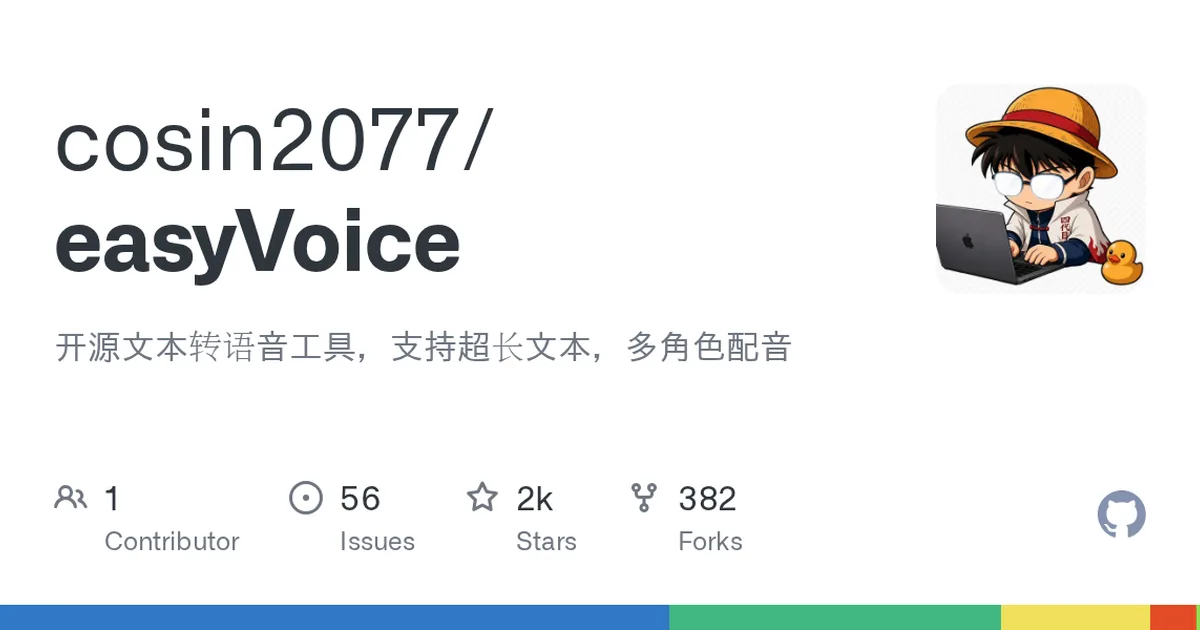
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-08-09 · 当前星标 ★ 2375
使用教程
环境要求
- Docker(使用 docker run 或 docker-compose 部署时)
- Node.js 环境(本地运行项目时)
- pnpm 包管理器(本地运行项目时,可用 corepack 开启或 npm 全局安装)
- 服务器或本地机器需开放 3000 端口
安装与启动步骤
-
1Docker 一键运行
最简单的方式,映射 3000 端口并把音频目录挂载到当前目录的 audio 下,可通过 -e 指定环境变量。
docker run -d -p 3000:3000 -v $(pwd)/audio:/app/audio cosincox/easyvoice:latest -
2克隆仓库用 Compose
把仓库克隆到本地后,使用 Docker Compose 一键启动服务,无需手动写 docker run 参数。
git clone git@github.com:cosin2077/easyVoice.git cd easyVoice docker-compose up -d -
3准备工作:Node 与 pnpm
本地运行前先确保已安装 Node.js,再开启或安装 pnpm;已有 pnpm 可跳过。
corepack enable npm install -g pnpm -
4拉取项目源码
从 GitHub 克隆 easyVoice 仓库并进入项目根目录,后续命令都在此目录执行。
git clone git@github.com:cosin2077/easyVoice.git cd easyVoice -
5安装项目依赖
使用 pnpm 递归安装工作区所有依赖,首次安装耗时较长属正常现象。
pnpm i -r -
6开发模式启动
适合调试和二次开发,启动后即可在浏览器访问本地服务。
pnpm dev:root -
7生产模式启动
先构建再启动,适合正式部署使用,构建完成后运行 start 命令拉起服务。
pnpm build:root
pnpm start:root
关键配置
| 配置项 | 必填 | 说明 | 示例 |
|---|---|---|---|
-e 环境变量 | 否 | docker run 时通过 -e 传入环境变量进行配置,README 未列出具体变量名 | -e KEY=value |
-v 挂载目录 | 否 | Docker 部署时把生成音频保存到宿主机指定目录 | -v $(pwd)/audio:/app/audio |
-p 端口映射 | 是 | 将容器 3000 端口映射到宿主机,接口与页面均走此端口 | -p 3000:3000 |
如何确认成功
浏览器访问 http://localhost:3000 能看到页面;或调用 curl -X POST http://localhost:3000/api/v1/tts/generateJson 有响应。
常见问题
Q:生成的音频和字幕文件保存在哪里?
A:Docker 部署保存在挂载的 audio 目录中;Node.js 本地运行保存在 ./packages/backend/audio 目录下。
Q:使用需要付费或有字数限制吗?
A:完全免费,无时长、无字数限制,支持将 10 万字以上的小说一键转为有声书。
Q:本地运行需要装什么?
A:需要 Node.js 环境,并准备 pnpm(可用 corepack enable 开启,或 npm install -g pnpm 安装)。
Q:能不能不装环境直接体验?
A:可以,官方提供在线体验地址 https://easyvoice.ioplus.tech,无需自行部署。
Q:文本太长会卡住吗?
A:支持流式传输,再长的文本也能迅速返回音频开始试听,无需等待全部合成完成。
注意事项
- Windows PowerShell 下 $(pwd) 语法不适用,需替换为实际宿主机路径。
- Docker 运行时注意 audio 挂载目录的读写权限,否则可能无法写入音频。
- 本地运行请先安装 Node.js,再执行 pnpm 相关命令。
- 接口调用地址为 http://localhost:3000/api/v1/tts/generateJson,需服务已启动。
核心亮点
- 基于微软 Edge TTS,音色自然且免费,无需自建模型
- 原生支持超长文本自动分段,避免截断问题
- 多角色配音能力突出,适合有声书、播客等场景
不足之处
- 依赖微软在线服务,离线环境无法使用
- 音色和语速等参数定制灵活性有限
- 文档/社区待观察
适用场景
- 将长篇小说、文章批量转为有声书音频
- 为视频、播客添加多角色对话配音
- 开发语音助手或内容生成应用时集成 TTS 能力
替代项目
Coqui TTS、Piper、Mimic 3
上一篇:voices
下一篇:ComfyUI-EdgeTTS
同类项目推荐
 Parakeet
开源
用 PaddlePaddle 一键训练和部署多种主流语音合成模型
PAddle PARAllel text-to-speech toolKIT (supporting Tacotron2, Transformer TTS, FastS···
 codename-rvc-fork-4
开源
一键克隆音色,实时转换歌声,创作更自由
Codename's rvc fork version 4, based on Applio.
 Irodori-TTS
开源
用表情符号控制语音风格,让 TTS 更生动自然
A Flow Matching-based Text-to-Speech Model with Emoji-driven Style Control
 StyleTTS2
开源
音色情绪几乎以假乱真,听不出是机器在读
StyleTTS 2: Towards Human-Level Text-to-Speech through Style Diffusion and Adversari···
 mustango
开源
用自然语言精准控制音乐生成,让每句描述都变成旋律。
Mustango: Toward Controllable Text-to-Music Generation
 Talkify
开源
几行代码给网页加上语音朗读,提升无障碍体验
Javascript Text to speech library
 flowflow
开源
用 Rust 打造本地优先语音笔记,自动转写并语义搜索。
Agentic Voice Notes for iPhone and macOS - Rust, Dioxus, LanceDB + RIG + SQLite
 smol-audio
开源
Colab 里直接跑通的音频模型微调与推理笔记本
Practical, Colab-friendly notebooks for fine-tuning and running audio AI models
 jamify
开源
像搭积木一样生成歌曲,每个音符都能控
JAM: A Tiny Flow-based Song Generator with Fine-grained Controllability and Aestheti···