

项目预览
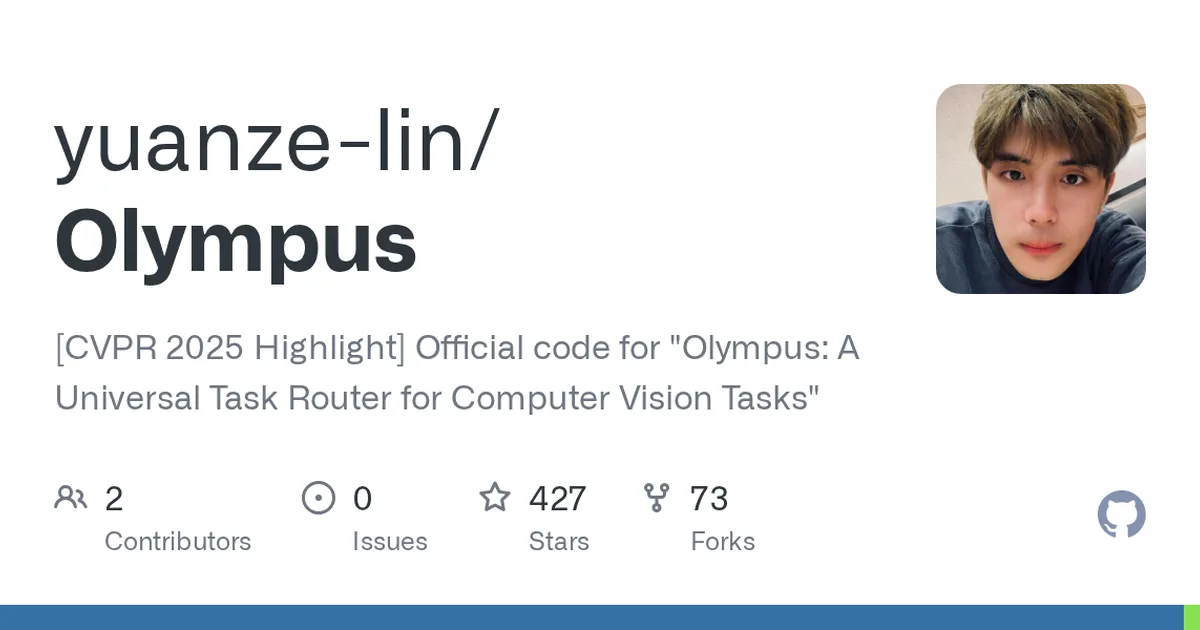
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-08-09 · 当前星标 ★ 427
使用教程
ℹ 本教程由 AI 依据该项目 README 整理,个别步骤可能需要按你的环境微调。
环境要求
- NVIDIA GPU(显存 16GB 起)
- CUDA
安装与启动步骤
-
1拉仓库
代码按视觉任务分目录,一个任务一套脚本。
git clone https://github.com/yuanze-lin/Olympus.git -
2建环境
官方指定 Python 3.10。
conda create -n olympus python==3.10 -y -
3装依赖
按 requirements 装,注意视觉模型版本。
pip install -r requirements.txt -
4先跑一个单任务
从目标检测或分割开始,确认权重加载正确。
-
5再试自然语言路由
一句指令跨多个视觉任务,这是它的核心卖点。
如何确认成功
一句包含两个子任务的指令(例如先找物体再判断属性)能被拆解并依次执行,而不是只做其中一个
注意事项
- 它把二十个视觉任务统一到一个模型里,靠指令路由而不是固定管线。
- 任务越多权重越大,显存占用比单任务模型高。
- 路由准确率决定体验,指令写得含糊会走错分支。
- 研究代码,脚本默认路径要改成本机配置。
- 输出用于生产前要评估误检率,尤其是医疗与工业场景。
核心亮点
- 提出任务路由器新范式,支持检测、分割、姿态等多种视觉任务统一调度
- 基于指令微调,能理解用户自然语言意图并自动匹配专家模型
- CVPR 2025 Highlight 认证,代码开源,PyTorch 实现,易于复现
不足之处
- 早期项目,社区生态和文档尚不完善
- 依赖多个外部视觉专家模型,部署复杂度较高
适用场景
- 构建通用视觉问答助手,回答关于图像内容的问题
- 自动化视觉任务流水线,根据输入动态选择处理模型
- 多模态研究,探索任务路由与模型组合的新方法
替代项目
LLaVA、InstructBLIP、Visual ChatGPT
同类项目推荐
 Conffusion
开源
给扩散模型生成结果加上统计置信区间,量化不确定性
Official Implementation for the "Conffusion: Confidence Intervals for Diffusion Mode···
 xview-yolov3
开源
用YOLOv3快速训练卫星图像目标检测模型
YOLOv3 training, preprocessing, validation, and inference for object detection in xV···
 Uni3D
开源
一个预训练模型搞定多种3D理解任务,零样本也能识别物体。
[ICLR'24 Spotlight] Uni3D: 3D Visual Representation from BAAI
 desk-ocr
开源
框选屏幕任意区域,OCR 取字后直接搜索,省去手动录入。
Capture your screen, extract text with OCR, and instantly search the recognized cont···
 VisCy
开源
显微图像自动提取单细胞特征,省去人工分析
computer vision models for single-cell phenotyping
 MulimgViewer
开源
一个界面并排看多图,对比拼接不用来回切窗口
MulimgViewer is a multi-image viewer that can open multiple images in one interface,···
 Churro
开源
让历史手稿和古籍轻松变成可搜索文本
CHURRO is an OCR toolkit for historical document transcription, built to make handwr···
 frigate-hass-integration
开源
把 Frigate AI 监控无缝接入 Home Assistant,实时看事件、玩自动化
Frigate integration for Home Assistant
 VISTA
开源
医学影像分割标注一站搞定
MONAI Versatile Imaging Segmentation and Annotation