

项目预览
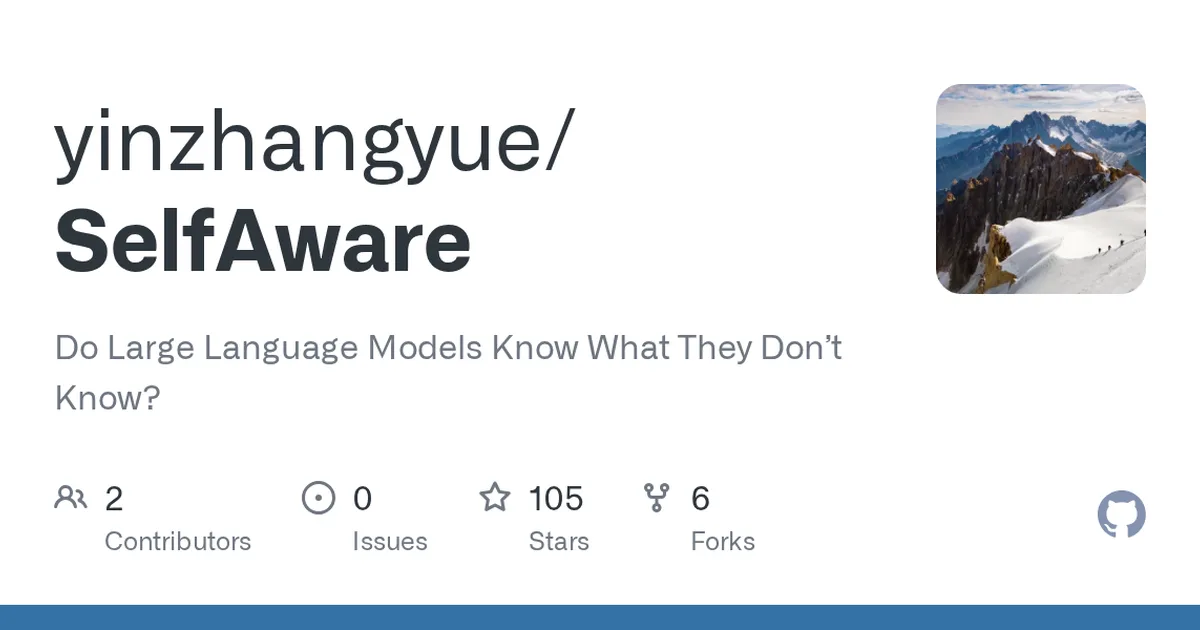
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-08-09 · 当前星标 ★ 107
核心亮点
- 聚焦模型自我认知这一前沿问题,研究视角独特
- 提供可复现的评估流程,便于对比不同模型表现
- 对构建更可靠的AI应用有直接参考价值
不足之处
- 项目处于早期阶段,文档和社区支持待观察
- 评估方法可能受限于特定测试集,泛化性待验证
适用场景
- 大模型能力基准测试与对比
- AI安全与幻觉问题研究
- 模型上线前的可靠性评估
替代项目
TruthfulQA、HaluEval、SelfCheckGPT
同类项目推荐
 Awesome-LVLM-Safety
开源
一页看懂视觉语言模型安全攻防与评测资源
A curated list of resources dedicated to the safety of Large Vision-Language Models.···
 Frontier-CS
开源
用开放式 CS 难题测出大模型的真实上限
A benchmark for evaluating LLMs on open-ended CS problems. Exploring the Next Fronti···
 AgentCapture
开源
给 AI 攻击代理布下诱饵,抓行为还能反制
Deception-layer honeypot that captures & reverse-controls AI pentest agents — embed···
 Awesome-MLLM-Uncertainty
开源
一页看尽多模态模型不确定性研究,快速定位关键论文
✨A curated list of papers on the uncertainty in multi-modal large language model (M···
 dep-scan
开源
扫依赖和镜像,查漏洞与许可证风险,出 SBOM
OWASP dep-scan is a next-generation security and risk audit tool based on known vuln···
 open-bias
开源
给 AI Agent 加一道策略防火墙,违规请求当场拦截
Open Source policy enforcement proxy: Make your agents follow rules.
 autoguardrails
开源
用 policy.md 自动搜索最优 LLM 护栏策略
Alignment-research scaffold (autoresearch-style) for LLM guardrails: search over a s···
 AttackVLM
开源
给视觉语言模型找茬,一键测出安全漏洞
[NeurIPS, 500+ Citations!] Alignment & Safety for multimodal foundation models
 HacxGPT-Jailbreak-prompts
开源
一键解锁 AI 模型隐藏能力,突破限制自由对话
HacxGPT Jailbreak : Unlock the full potential of top AI models like ChatGPT, LLaMA, ···