

项目预览
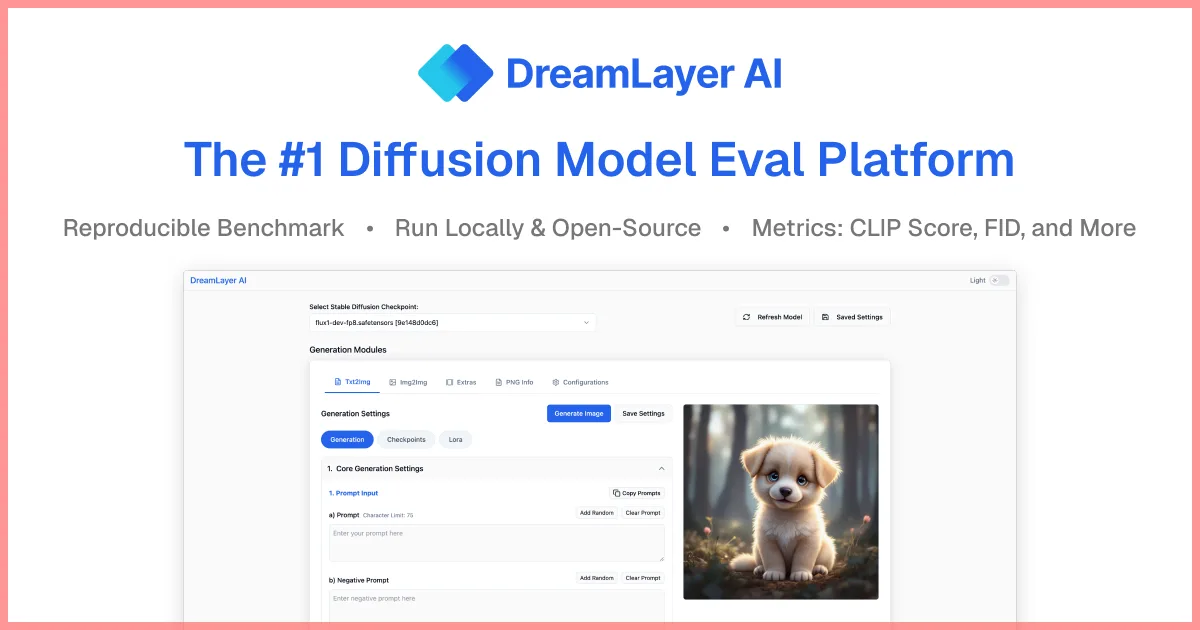
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-08-09 · 当前星标 ★ 412
使用教程
ℹ 本教程由 AI 依据该项目 README 整理,个别步骤可能需要按你的环境微调。
环境要求
- Node.js 20+
- Python 3.10+
- (评测模型)NVIDIA GPU
安装与启动步骤
-
1装两套依赖
前端与研究侧环境分开装。
.venv-research/bin/python -m pip install -r requirements-research.lock.txt -
2起本地工作台
它绑本机地址,不对外。
npm run dev -- --host 127.0.0.1 --port 8080 -
3导入一组素材
图片与视频都能评,先小批量。
-
4固定评分口径
同一套标准重跑,才谈得上可复现。
如何确认成功
同一批素材用同一配置重跑两次,评分结果一致,且能看到每条素材的评分依据
注意事项
- 它是本地评测工作台,重点是可复现而不是打分高低。
- 评分口径不固定时,两次结果没有可比性。
- 评测依赖模型判断,模型换版本结果就会变。
- 素材涉及版权与肖像,本地存放要控访问。
- 研究侧依赖锁定在文件里,别随意升级。
核心亮点
- 自动化管理种子和配置,确保评测结果可复现
- 内置多种主流评估指标,开箱即用
- 接口简洁,易于集成到现有模型开发流程
不足之处
- 文档/社区待观察
- 早期项目,功能覆盖可能不够全面
适用场景
- 对比不同扩散模型版本或超参的生成质量
- 在论文或技术报告中生成标准化的模型评估数据
- 作为 CI/CD 流程中的模型回归测试工具
替代项目
FID Score、CLIP Score、T2I-CompBench
上一篇:vistorybench
下一篇:clean-fid
同类项目推荐
 MarkDiffusion
开源
给扩散模型生成图加水印,统一接口做嵌入、提取与评测
[JMLR] MarkDiffusion: An Open-Source Toolkit for Generative Watermarking of Latent D···
 benchmark
开源
用200个真实网页任务,跑分对比你的浏览器AI智能体
Open benchmarks for browser agents: BU Bench V2.1, 200 real web tasks. Rerun them wi···
 VEFX-Bench
开源
给视频编辑和特效模型打分,选型不再靠感觉
VEFX-Bench: A Holistic Benchmark for Generic Video Editing and Visual Effects
 Zero-Breach-Toolkit
开源
离线自查设备是否留有已知间谍软件痕迹
Free, open-source check for traces of mercenary spyware (Pegasus, Predator, Graphite···
 dingo
开源
一键评测AI数据与模型质量,自动出报告
Dingo: A Comprehensive AI Data, Model and Application Quality Evaluation Tool
 Awesome-LM-SSP
开源
一网打尽大模型安全、隐私攻防的精华资料,快速跟上前沿。
A reading list for large models safety, security, and privacy (including Awesome LLM···
 AgentBench
开源
一套基准测出 LLM 当智能体到底行不行
A Comprehensive Benchmark to Evaluate LLMs as Agents (ICLR'24)
 ai-safe2-framework
开源
给 AI 智能体装上治理与合规操作系统,让 AI 安全落地。
The Universal Governance, Risk, Compliance (GRC) Operating System with Integrated Se···
 jevals
开源
每条 trace 一次请求,几分钱延迟低到能进 Agent 循环
Agent evals and guardrails as Jev decisions: one request per trace, a fraction of a ···