

项目预览
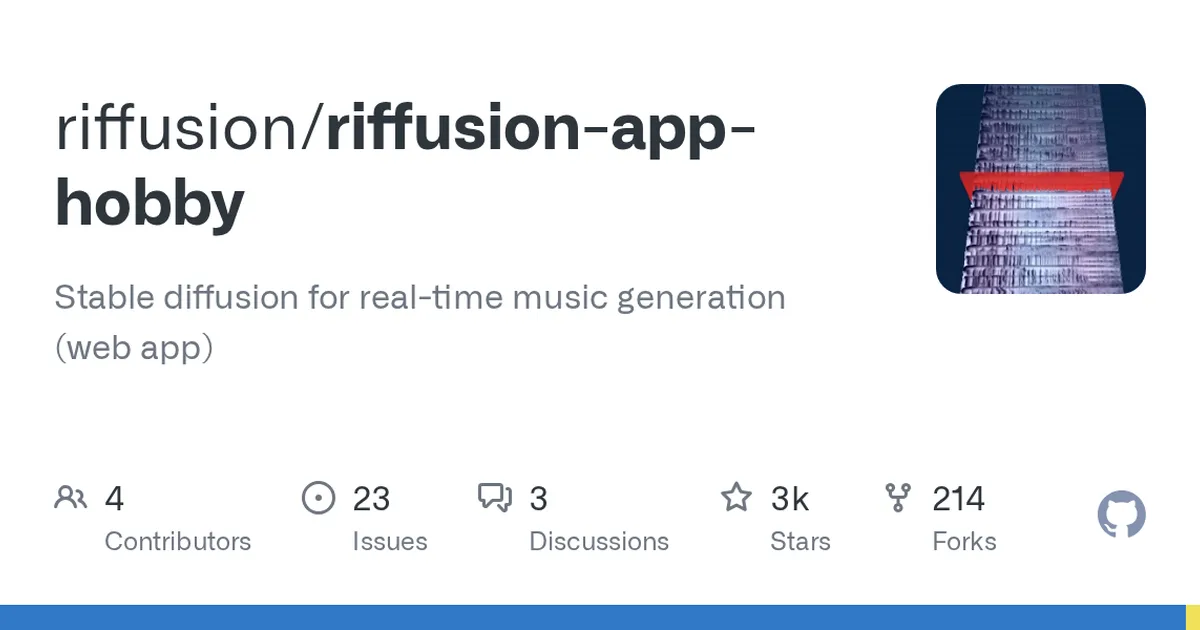
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-08-09 · 当前星标 ★ 2671
使用教程
环境要求
- Node.js v18 或更高版本(用 node --version 确认)
- npm 或 yarn 包管理器
- 如需真正生成音乐,需要一台能 5 秒内跑完 stable diffusion 的大显存 GPU 机器,并部署 riffusion-inference 推理服务
- 可访问 GitHub 与 npm 源(首次安装依赖需要联网)
安装与启动步骤
-
1检查 Node 版本
打开终端执行命令,确认输出为 v18 或更高。版本过低会导致 Next.js 启动失败,需先升级 Node。
node --version -
2安装项目依赖
在仓库根目录执行 npm install 安装 Next.js、React、three.js、Tailwind 等依赖,首次安装耗时较长。
npm install -
3启动开发服务器
运行开发模式,Next.js 会启动本地服务并支持热更新。也可用 yarn dev 代替 npm run dev。
npm run dev yarn dev -
4浏览器打开应用
在浏览器访问 http://localhost:3000 即可看到应用首页,页面源码在 pages/index.js,关于页在 pages/about.tsx。
-
5接入推理服务
仅启动前端无法生成模型输出。需先按 riffusion-inference 仓库说明用 GPU 跑 Flask 推理服务,再在根目录新建 .env.local 指定其 URL。
如何确认成功
终端出现开发服务器就绪提示且无报错,浏览器打开 http://localhost:3000 能看到 Riffusion 应用首页。
常见问题
Q:必须部署推理服务器才能用吗?
A:不部署也能启动网页并浏览界面,但生成音频需要后端模型输出,必须另跑 riffusion-inference 服务并在 .env.local 中填写其地址。
Q:可以用 yarn 代替 npm 吗?
A:可以,README 给出 npm run dev 与 yarn dev 两种启动方式,依赖安装对应使用 yarn install 即可。
Q:这个项目还在维护吗?
A:README 顶部明确标注项目已不再积极维护,遇到依赖版本或接口问题可能不会得到修复。
Q:推理服务放在哪里?
A:README 指向 hmartiro/riffusion-inference 仓库,按其说明克隆并运行 Flask app,本仓库只负责前端界面与调用。
注意事项
- 项目已停止积极维护,仅适合学习或实验用途。
- README 中 .env.local 的具体配置项名称被截断,请以原仓库 Inference Server 一节为准,不要凭猜测填写键名。
- 推理服务对 GPU 要求较高(需在 5 秒内完成一次 stable diffusion 推理),普通笔记本难以满足。
- 页面自动热更新,修改 pages/index.js 后无需重启即可看到变化。
核心亮点
- 实时生成:基于 Web 界面,参数调整后秒级生成音频,交互流畅
- 技术新颖:将图像扩散模型迁移到音频频谱图,思路独特且可玩性强
- 可视化体验:Three.js 提供频谱图 3D 可视化,创作过程直观有趣
不足之处
- 生成音乐质量有限,复杂旋律和和声表现力不足
- 文档/社区待观察:项目处于早期,教程和社区资源较少
适用场景
- 音乐人快速生成灵感片段或背景音乐
- 开发者学习扩散模型在音频领域的应用
- 艺术家创作互动式声音艺术装置
替代项目
AudioLDM、MusicGen、Diffusion-LM
上一篇:riffusion-hobby
下一篇:so-vits-models
同类项目推荐
 pocket-tts
开源
普通 CPU 也能本地跑的文字转语音工具
A TTS that fits in your CPU (and pocket)
 AdaSpeech
开源
用几秒参考音频,快速克隆出你的专属AI音色
An implementation of Microsoft's "AdaSpeech: Adaptive Text to Speech for Custom Voic···
 draft-to-take
开源
本地一键将语音草稿打磨成专业音频成品
Draft to Take beta: local-first AI audio production studio powered by IndexTTS2, Doc···
 ZeroSpeech-TTS-without-T
开源
无需文本标注,直接从语音学习并合成语音,攻克低资源TTS难题。
A Pytorch implementation for the ZeroSpeech 2019 challenge.
 FlashLabs-Chroma
开源
实时语音对话+声音克隆,几秒复刻你的音色
Worlds first open-source real-time end-to-end spoken dialogue model with personalize···
 pitchtron
开源
让韩语方言TTS说对音调,不再怪腔怪调
TTS for pitch-accented language. Korean dialect DB.
 qwen3-tts
开源
纯 C 跑 Qwen3-TTS,无 Python 依赖,轻量高效部署
Pure C inference engine for Qwen3-TTS text-to-speech. No Python, no PyTorch — just ···
 zai-tts
开源
把智谱 TTS 变成 OpenAI 接口,免费克隆音色,无缝切换
️ ZAI/GLM TTS to OpenAI Speech API, 免费的语音合成API,支持克隆音色,基于智谱TTS
 murf-python-sdk
开源
一行代码,让 Python 应用开口说话
Python sdk for Murf text to speech API