

WhisperLiveKit
本地实时语音转文字,兼容 OpenAI/Deepgram API,秒级部署
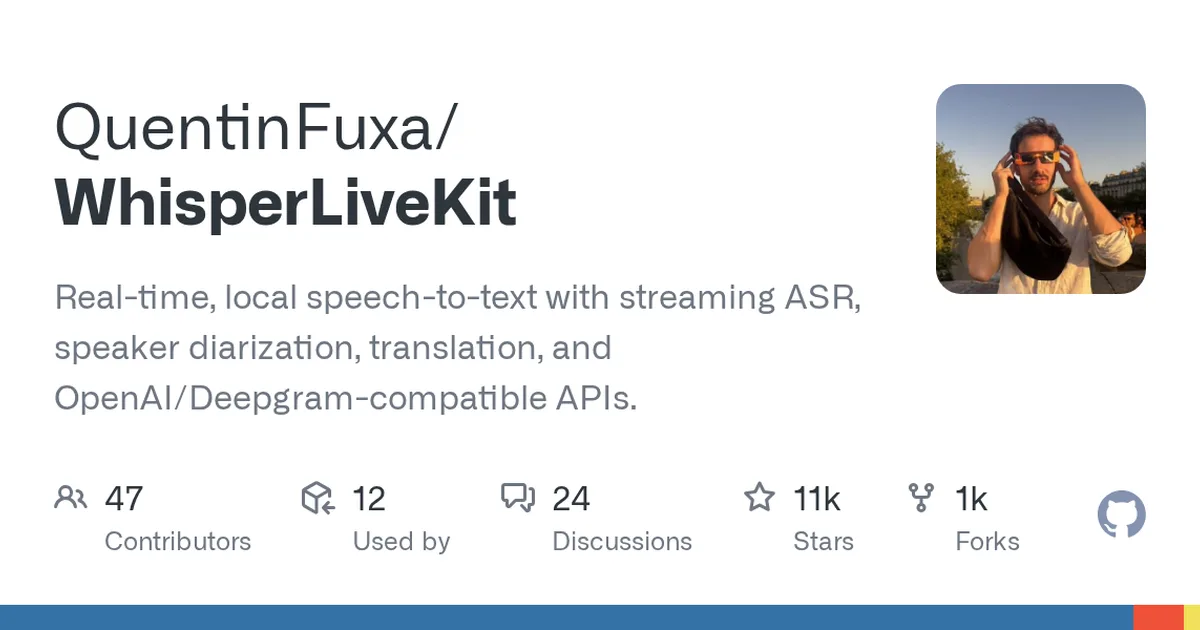
项目预览
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-08-17 · 当前星标 ★ 11251
使用教程
ℹ 本教程由 AI 依据该项目 README 整理,个别步骤可能需要按你的环境微调。
环境要求
- Python 3.11 ~ 3.13
- 已安装 pip(用于安装 whisperlivekit 包)
- 默认音频处理依赖 FFmpeg(使用 --pcm-input 可绕过)
- 可选 GPU:支持 CUDA / Apple Silicon(MLX、MPS);纯 CPU 也可运行
安装与启动步骤
-
1安装 whisperlivekit
README 提供的唯一安装方式,用 pip 从 PyPI 安装。建议在虚拟环境中执行,避免污染系统环境。
pip install whisperlivekit -
2启动转录服务
启动本地服务,默认模型 small、监听 localhost:8000。模型首次运行会自动下载,需保证网络可用。
whisperlivekit-server --model small --host localhost --port 8000 -
3开启说话人分离
加上 --diarization 可区分不同发言者,默认使用 sortformer 后端。需要额外模型权重,首次加载较慢。
whisperlivekit-server --model small --diarization -
4开启实时翻译
用 --target-language 指定目标语言,默认走 NLLB 在进程内翻译,CPU 友好;语言列表见 docs/supported_languages.md。
whisperlivekit-server --model small --target-language zh -
5切换 ASR 后端
--backend 可选 mlx-whisper、faster-whisper、whisper、openai-api、funasr、qwen3-streaming、canary 等,auto 会按平台自动选择。
whisperlivekit-server --backend faster-whisper --model small
关键配置
| 配置项 | 必填 | 说明 | 示例 |
|---|---|---|---|
--model | 否 | Whisper 模型规格,越大越准但越慢 | small |
--host | 否 | 服务监听地址,默认 localhost | localhost |
--port | 否 | 服务监听端口,默认 8000 | 8000 |
--language | 否 | 识别语言,auto 表示自动检测但偏向英语 | auto |
--target-language | 否 | 设置后启用 NLLB 实时翻译到目标语言 | zh |
--backend | 否 | ASR 后端选择,auto 按平台自动挑 | auto |
如何确认成功
服务启动后监听 http://localhost:8000,浏览器打开该地址即可看到前端界面,对着麦克风说话能看到实时转写文字。
常见问题
Q:端口 8000 被占用怎么办?
A:启动时加 --port 指定其他端口,例如 --port 8080,然后访问 http://localhost:8080 即可。
Q:想用 HTTPS 访问怎么办?
A:使用 --ssl-certfile 和 --ssl-keyfile 分别指定证书与私钥文件路径,服务即以 HTTPS 方式提供。
Q:前端要用别的域名访问,CORS 报错?
A:用 --cors-origins 传入逗号分隔的允许来源列表,或用 * 允许全部来源,留空则关闭 CORS。
Q:模型下载很慢或想用本地模型?
A:可用 --model-path 指定本地 .pt 文件/目录或 Hugging Face 仓库 ID,它会覆盖 --model 设置。
Q:识别延迟高怎么调?
A:可尝试 --asr-coalesce-min-s 增大累积音频以减少编码次数,或 --backend-policy localagreement 换策略。
注意事项
- README 未给出前端页面地址的完整示例,仅从 --port 默认 8000 推断访问入口,请以实际启动日志为准。
- --no-vac / --no-vad 会关闭语音活动检测,README 明确标注 NOT ADVISED,不建议关闭。
- --warmup-file 默认使用 jfk.wav 做模型预热,若该文件不存在可能影响首次启动体验。
- --pcm-input 模式下输入需为 raw PCM (s16le) 且会绕过 FFmpeg,前端改用 AudioWorklet。
核心亮点
- 流式 ASR 延迟低,支持实时字幕和交互
- 内置说话人分离,区分发言者提升会议记录效率
- 兼容 OpenAI 和 Deepgram API,迁移成本低
不足之处
- 对硬件资源要求较高,需 GPU 才能流畅运行大模型
- 文档/社区待观察
适用场景
- 实时会议字幕与记录
- 语音助手和交互式应用
- 本地化语音转写服务(如医疗、法律等敏感领域)
替代项目
whisper.cpp、faster-whisper、Vosk
同类项目推荐
 EasyMrcp
开源
用 Java 轻松接入多家语音识别与合成服务
欢迎使用EasyMrcp! EasyMrcp使用java编写,目前提供了多种不同的asr和tts的集成,做到真正···
 openwhispr
开源
本地优先的语音转文字,隐私不妥协,跨平台即装即用。
Voice-to-text dictation app with local (Nvidia Parakeet/Whisper) and cloud models (B···
 viet-asr
开源
越南语语音转文字的开源基线
viet-asr - Vietnamese Automatic Speech Recognition
 obs-localvocal
开源
直播录屏时,本地AI实时生成字幕,保护隐私零延迟
OBS plugin for local speech recognition and captioning using AI
 ollama-voice-mac
开源
在 Mac 上对着本地大模型说话,解放双手,秒得语音回复。
Mac compatible Ollama Voice
 spokestack-python
开源
在嵌入式设备上快速集成离线语音交互,无需云端依赖。
Spokestack is a library that allows a user to easily incorporate a voice interface i···
 TranscriptHub
开源
上传音频,自动出带时间戳的文字稿
 whisperX-FastAPI
开源
上传音频,直接拿到带时间戳和说话人标签的转写接口
[Archived, unmaintained] FastAPI service on top of WhisperX
 LiveWhisper
开源
让 Whisper 实时出字,终端语音输入即说即显
A nearly-live implementation of OpenAI's Whisper, using sounddevice. Requires existi···