
项目预览
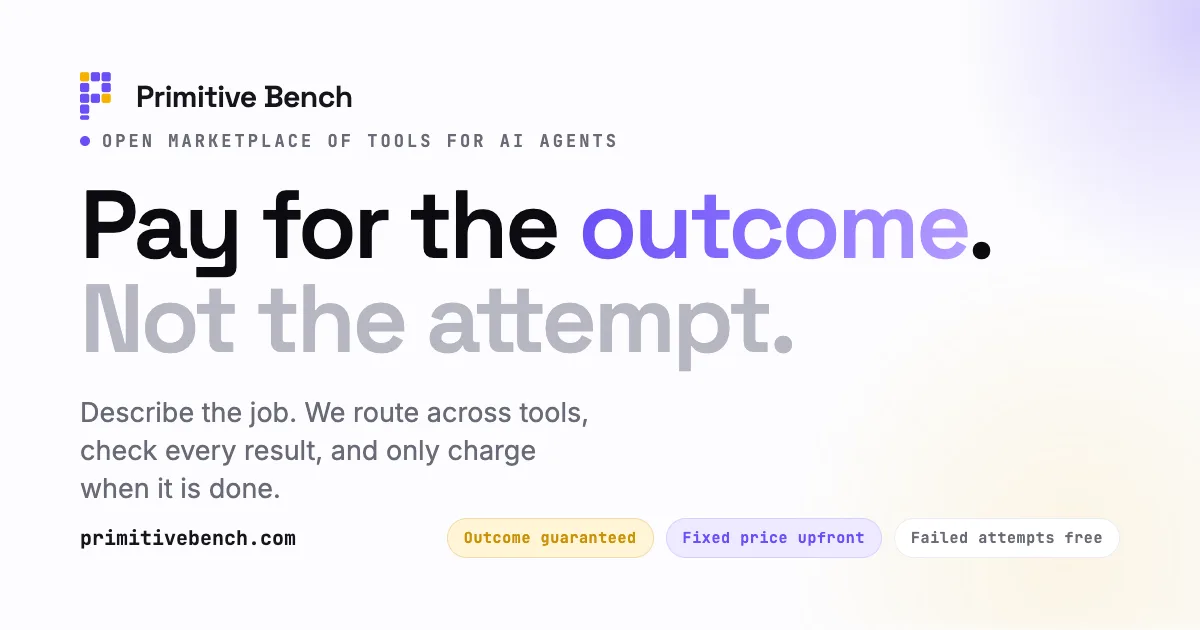
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-09-30 · 当前星标 ★ 122
核心亮点
- 把固定报价、工具路由、结果验证和退款做成闭环,AI 交付有兜底
- 开源验证层可独立接入,便于审计 AI 输出是否真正满足任务
- 覆盖 OCR、检索、重排、MCP 工具调用等,适合多工具组合型 Agent 评测
不足之处
- 项目早期,星标仅 122,生态与生产案例有限
- 验证层对复杂主观任务的判定边界和准确率仍需更多公开评测
适用场景
- 企业采购 AI 数据处理服务,按任务固定报价并要求未达标退款
- Agent 团队在发布前用可验证基准回归工具调用与检索效果
- 平台方对第三方 AI 工具做结果验收与自动结算
替代项目
OpenAI Evals、LangSmith、Braintrust
同类项目推荐
 L1B3RT4S
开源
玩转 AI 提示词,用幽默解锁创意交互
TOTALLY HARMLESS LIBERATION PROMPTS FOR GOOD LIL AI'S!
 context-bombs
开源
用现成的攻击字符串,测出你的 AI 系统抗不抗揍。
Context bomb strings
 XRAG
开源
给 RAG 系统做全面体检,量化每个核心模块的真实实力
XRAG: eXamining the Core - Benchmarking Foundational Component Modules in Advanced R···
 SafeGen_CCS2024
开源
给文生图模型加安全锁,推理时自动过滤违规内容
[CCS'24] SafeGen: Mitigating Unsafe Content Generation in Text-to-Image Models
 overmind
开源
追踪+评测+微调,让 Agent 越用越准
The platform for continuously improving AI agents.
 SkillEvaluator
开源
给 Agent 技能做体检:查冲突、测安全、验效果
Multi-tier framework for evaluating AI agent skills with quality gates, semantic ove···
 sample-agent-cost-bench
开源
横向评测编程代理的成本、质量与耗时
Benchmark framework that measures cost, quality, and duration of coding agents acros···
 svelte-bench
开源
专测大模型写 Svelte 5 代码行不行
An LLM benchmark for Svelte 5 based on the OpenAI methodology from OpenAIs paper "Ev···
 Spiritual-Spell-Red-Teaming
开源
用现成越狱提示快速测出大模型安全漏洞
A repo for jailbreaking various LLMs, mainly Claude