
项目预览
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-08-09 · 当前星标 ★ 3630
使用教程
ℹ 本教程由 AI 依据该项目 README 整理,个别步骤可能需要按你的环境微调。
环境要求
- Python 环境(需安装 requests 库)
- Oxylabs 账号:Web Scraper API 的 USERNAME 和 PASSWORD(可注册免费试用)
- 可访问 https://realtime.oxylabs.io/v1/queries 的网络环境
安装与启动步骤
-
1注册获取凭据
在 Oxylabs dashboard 注册账号申请免费试用,拿到 Web Scraper API 的用户名和密码,后续请求要用。
-
2安装 requests 库
在 Python 环境中安装发起 HTTP 请求所需的 requests 依赖库。
pip install requests -
3编写请求脚本
新建 .py 文件,填入 payload 并把 USERNAME、PASSWORD 换成自己的真实凭据。
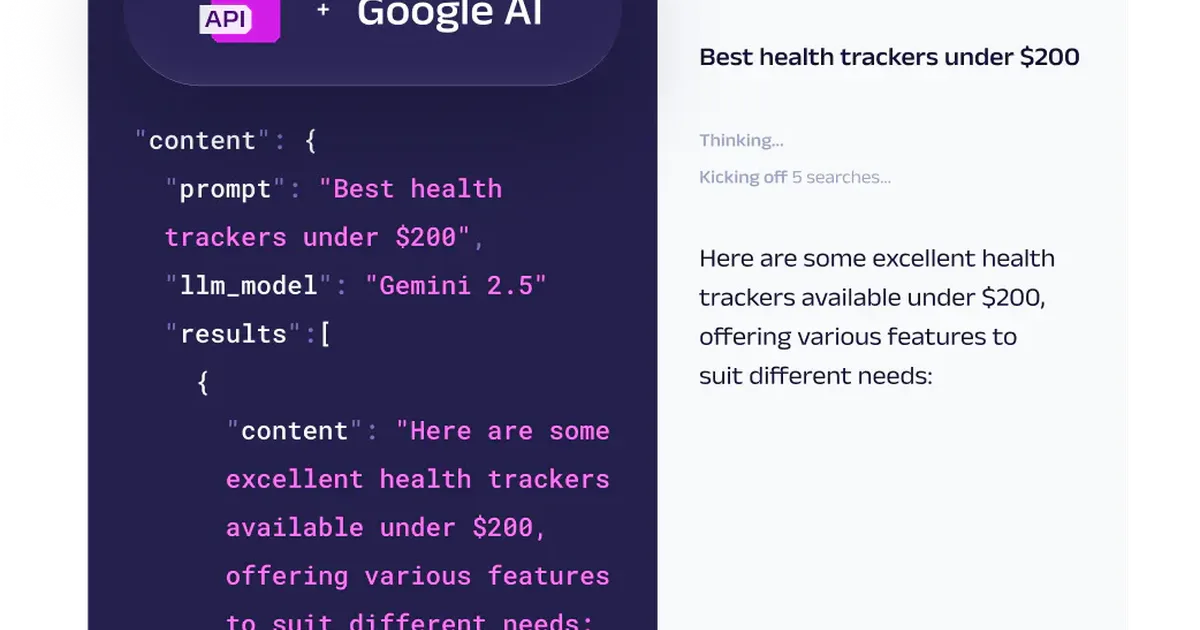
import json import requests # API parameters. payload = { 'source': 'google_ai_mode', 'query': 'best health trackers under $200', 'render': 'html', 'parse': True, 'geo_location': 'United States' } # Get a response. response = requests.post( 'https://realtime.oxylabs.io/v1/queries', auth=('USERNAME', 'PASSWORD'), json=payload ) print(response.json()) -
4运行并取回结果
执行该脚本向接口发送 POST 请求,返回内容即解析后的 Google AI Mode 响应 JSON。
-
5调整抓取参数
按需修改 query 提问内容、geo_location 地区、render 与 parse 选项后重跑脚本。
关键配置
| 配置项 | 必填 | 说明 | 示例 |
|---|---|---|---|
source | 是 | 指定抓取目标为 Google AI Mode,固定值不可改 | google_ai_mode |
query | 是 | 要向 Google AI Mode 发送的提示词/搜索问题 | best health trackers under $200 |
geo_location | 否 | 指定搜索来源地区,影响返回结果的本地化内容 | United States |
render | 否 | 控制返回渲染形式,示例中使用 html | html |
parse | 否 | 是否由接口直接返回解析后的结构化数据 | True |
USERNAME/PASSWORD | 是 | Web Scraper API 认证凭据,需替换为账号真实值 | USERNAME: my_user / PASSWORD: my_pass |
如何确认成功
脚本能正常返回响应,且 body 为 JSON 格式的 Google AI Mode 解析结果,即抓取成功。
常见问题
Q:没有 Oxylabs 账号能用吗?
A:不能。该抓取走 Oxylabs Web Scraper API,需先在 dashboard 注册并获取 USERNAME/PASSWORD,可申请免费试用。
Q:需要自己准备代理或浏览器吗?
A:不需要。API 已代为处理代理、无头浏览器和自动化请求系统,你只需发 POST 请求。
Q:只有 Python 示例吗?
A:README 提供 Python 示例,仓库 Code examples 目录还有更多语言样例可参考。
Q:抓取结果怎么用?
A:可用于 SEO 与 GEO 项目、构建训练数据集,或其他需要 AI 搜索生成内容的数据任务。
Q:返回什么格式的数据?
A:接口以 JSON 格式返回已解析的数据,直接取响应体的 JSON 即可使用。
注意事项
- README 中 Python 示例的认证部分被截断,请以仓库 Code examples 目录的完整样例为准。
- 务必把示例里的 USERNAME、PASSWORD 替换成自己的真实凭据,不要直接提交到公开仓库。
- 抓取需遵守目标网站条款与当地法律法规,仅用于合规的数据采集用途。
核心亮点
- 专为 Google AI Mode 定制,能绕过大规模抓取限制,稳定性优于通用爬虫方案。
- 基于 Java 实现,技术栈清晰,集成代理池与 AI 训练数据采集能力,适合构建数据管道。
- 作为 Firecrawl 替代方案,提供更聚焦的 AI 搜索响应抓取,降低二次开发成本。
不足之处
- 依赖代理质量,免费代理易失效,需自建代理池或付费服务,增加运维成本。
- 仅支持 Google AI Mode 单一目标,若目标平台变更或封禁策略升级,需频繁适配。
- 文档/社区待观察
适用场景
- 大规模采集 Google AI Mode 搜索结果用于大模型训练数据构建。
- 构建 AI 搜索竞品分析或舆情监控系统,需实时获取 AI 摘要内容。
- 作为 Firecrawl 等通用抓取工具的补充,专门处理 AI 搜索响应格式。
替代项目
Firecrawl、Scrapy、Apify
上一篇:Scrapegraph-ai
下一篇:swirl-search
同类项目推荐
 ketch
开源
让 AI 代理秒搜网页,无状态抓取快人一步
Fast, stateless CLI for web search and scrape. Built for AI agents.
 Hyper-RAG
开源
用超图建模文档关系,让 RAG 检索更准,减少幻觉。
"Hyper-RAG: Combating LLM Hallucinations using Hypergraph-Driven Retrieval-Augmented···
 arxiv-mcp-server
开源
用自然语言搜索和分析 arXiv 论文,快速获取研究要点
A local MCP server for agent literature work. Original-LaTeX section reads, BibTeX f···
 rag-all-in-one
开源
一站式搞定 RAG 应用开发,从入门到落地少走弯路
Guide to Building RAG (Retrieval-Augmented Generation) Applications
 colpali-cookbooks
开源
手把手教你微调 ColPali,让多模态文档检索更精准
Recipes for learning, fine-tuning, and adapting ColPali to your multimodal RAG use c···
 edgequake
开源
用 Rust 把文档变成知识图谱,让 AI 检索更聪明
EdegQuake High-performance GraphRAG inspired from LightRag written in Rust; Transfo···
 DocPaws
开源
让文档问答有据可查,拒绝瞎编,工程化 RAG 开箱即用
工程化 RAG 文档助手:知识库、PDF 索引、Agent 工具编排、scope 检索、引用溯源与拒答阈值···
 LLMSearchRecommender
开源
一份读懂大模型做搜索推荐问答的资料地图
This compendium reviews significant published research contributions and industrial ···
 RAG_langchain
开源
跑通一个 Notebook,看懂 RAG 全流程
一个基于langchain实现RAG的简单示例