

项目预览
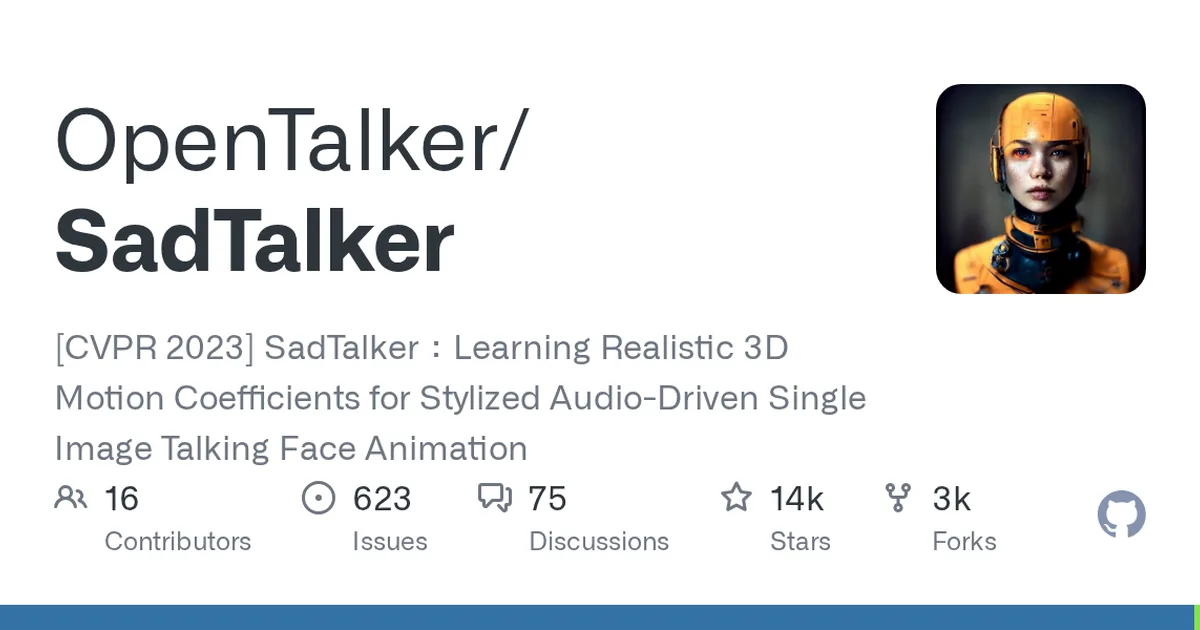
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-08-09 · 当前星标 ★ 14192
使用教程
ℹ 本教程由 AI 依据该项目 README 整理,个别步骤可能需要按你的环境微调。
环境要求
- 可用的 Python 运行环境(项目为 Python 实现)
- Linux/Mac 终端或 Windows 命令行环境
- 首次运行需联网自动安装 requirements 依赖
- 若需语音合成能力,需额外安装 TTS
- Docker / WSL 用户请参考官方 docs/install.md 额外教程
安装与启动步骤
-
1获取项目代码
从 GitHub 克隆 SadTalker 仓库到本地,然后进入项目目录。若网络受限可自行配置代理。
git clone https://github.com/OpenTalker/SadTalker.git cd SadTalker -
2安装依赖并启动
Linux/Mac 执行脚本会自动安装 requirements 并启动 WebUI;Windows 则直接双击 webui.bat 同样自动装依赖。
bash webui.sh -
3安装 TTS(可选)
只有需要 TTS 语音合成高级功能时才需要手动安装,普通口型生成可跳过这一步。
pip install tts -
4手动启动 WebUI
依赖装好后也可直接启动网页界面,在浏览器中进行图片+音频的交互式生成。
python app_sadtalker.py -
5命令行生成视频
用默认配置驱动单张人像说话,enhancer 参数可提升画质;结果保存在 results 下的时间戳目录。
python inference.py --driven_audio <audio.wav> --source_image <video.mp4 or picture.png> --enhancer gfpgan -
6全身/完整图像模式
加 --still 生成更自然的全身视频,配合 --preprocess full 做完整图像预处理,并指定结果输出目录。
python inference.py --driven_audio <audio.wav> --source_image <video.mp4 or picture.png> --result_dir <a file to store results> --still --preprocess full --enhancer gfpgan
关键配置
| 配置项 | 必填 | 说明 | 示例 |
|---|---|---|---|
--driven_audio | 是 | 驱动用的语音音频文件路径 | <audio.wav> |
--source_image | 是 | 输入的人像图片或视频文件路径 | <video.mp4 or picture.png> |
--result_dir | 否 | 指定结果输出目录,不填则用默认 results 时间戳目录 | <a file to store results> |
--still | 否 | 开启后生成更自然的全身视频效果 | --still |
--preprocess | 否 | 预处理模式,full 表示使用完整图像 | full |
--enhancer | 否 | 人脸增强器,用于提升生成视频画质 | gfpgan |
如何确认成功
浏览器打开 WebUI 页面可正常操作,或在 results/$SOME_TIMESTAMP/ 目录下看到生成的 .mp4 文件即成功。
常见问题
Q:Windows 上怎么启动最简单?
A:直接双击项目目录下的 webui.bat 即可,脚本会自动安装依赖并启动 WebUI。
Q:Linux 或 Mac 上如何启动?
A:在项目目录执行 bash webui.sh,会自动安装依赖并启动 WebUI。
Q:生成的结果保存在哪里?
A:默认保存在 results/$SOME_TIMESTAMP/*.mp4,可用 --result_dir 自定义输出目录。
Q:必须安装 TTS 吗?
A:不是必须的。README 说明只有使用 TTS 相关高级功能时才需要通过 pip install tts 手动安装。
Q:想在 Docker 或 WSL 里跑怎么办?
A:README 提供了额外教程,请查看项目内 docs/install.md 的说明。
注意事项
- 首次运行会自动下载依赖和模型,耗时较长且需保证网络通畅。
- Docker、WSL 等环境的安装方式另见官方 docs/install.md。
- 更多参数示例和调优建议请阅读官方 docs/best_practice.md。
- README 提供了中文 Windows 视频教程与日文教程链接,遇到问题可参考。
核心亮点
- 口型同步精准,基于3D运动系数,自然度远超传统2D方法
- 支持多种风格(真实/卡通/素描),适配不同应用场景
- 提供WebUI和API,上手快,便于集成到现有系统
不足之处
- 生成视频分辨率有限,高分辨率输出需额外处理
- 对输入人脸角度和遮挡敏感,侧面或遮挡时效果下降
- 文档/社区待观察
适用场景
- 短视频制作:快速生成虚拟主播或人物讲解视频
- 在线教育:将课件文本转为带口型动画的虚拟教师
- 游戏/影视预演:用角色立绘生成对话动画
替代项目
Wav2Lip、GeneFace、Audio2Face
下一篇:FaceTalk
同类项目推荐
 Paint3D
开源
给 3D 模型一键生成无光照纹理,告别烘焙阴影
[CVPR 2024] Paint3D: Paint Anything 3D with Lighting-Less Texture Diffusion Models, ···
 ShapeGPT
开源
用一句话生成3D模型,让设计触手可及
ShapeGPT: 3D Shape Generation with A Unified Multi-modal Language Model, a unified a···
 Virtual_Avatar_ChatBot
开源
低配电脑本地跑,打造你的专属AI虚拟老婆
To create a free AI Chatbot/Waifu/ Vtuber that will run on your local computer with ···
 avatar-generator
开源
组合特征一键生成卡通头像组件
Personas, an avatar generator by Draftbit
 avatar-compressor
开源
虚拟形象无损压缩,原文件不动、体积变小
LAC: Avatar Compressor: Non-Destructive Avatar Compression Utilities
 avatar-mix
开源
一键生成数字人短视频并自动发布到全网
Generate 16:9 & 9:16 videos with your HeyGen avatar, animated backgrounds (HyperFram···
 lobe-vidol
开源
拖拽搭建专属虚拟偶像,会聊天能唱歌
Lobe Vidol - Making Virtual Idols Accessible for EveryOne
 Talking_Face_Avatar
开源
一张图+一段音频,生成会说话的角色头像视频
Avatar Generation For Characters and Game Assets Using Deep Fakes
 reflect3r
开源
单张照片+镜子,重建出完整 3D 立体模型
[3DV 2026] Reflect3r: Single-View 3D Stereo Reconstruction Aided by Mirror Reflectio···