

项目预览
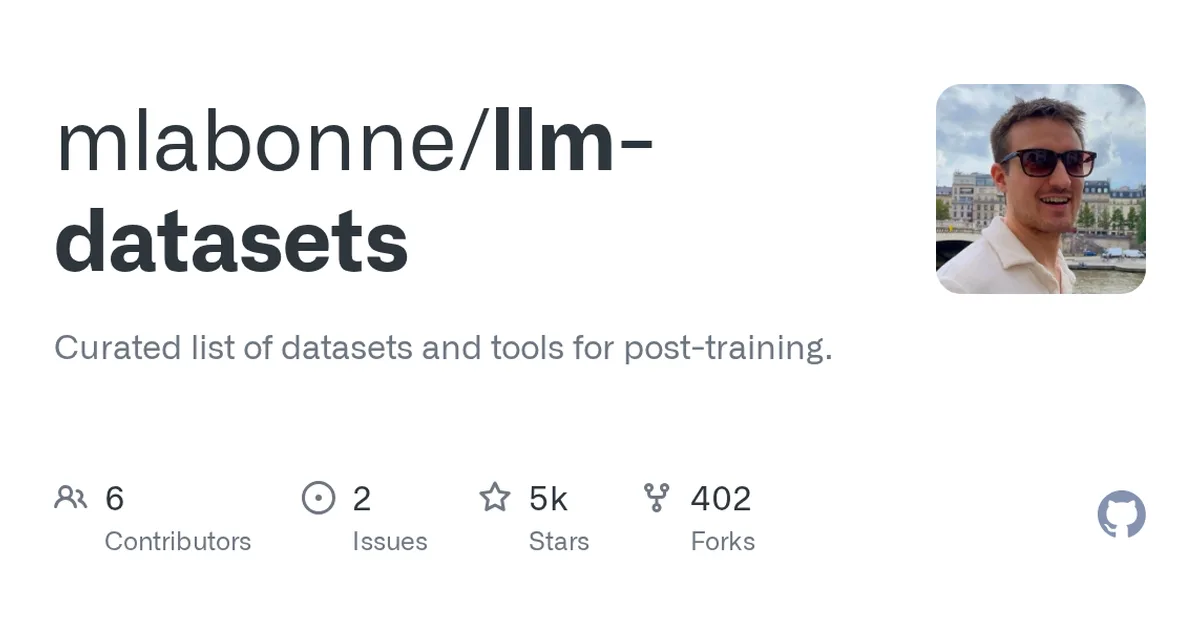
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-08-09 · 当前星标 ★ 4830
使用教程
⚠ 本教程由 AI 依据该项目 README 整理;原始文档不完整,部分步骤为通用流程推断,实际安装请以项目官方文档为准。
⚠ 该项目 README 未提供完整安装说明,以下步骤为通用流程,请以官方文档为准。
环境要求
- 可访问 GitHub 与 Hugging Face 的网络环境
- 已安装 git(用于克隆仓库)
- 能阅读 Markdown 的工具(浏览器或编辑器即可)
安装与启动步骤
-
1克隆清单仓库
把 llm-datasets 仓库下载到本地,方便离线查阅数据集清单与说明。
git clone https://github.com/mlabonne/llm-datasets.git -
2进入项目目录
切换到克隆下来的目录,后续所有查看操作都在此目录内进行。
cd llm-datasets -
3阅读数据集清单
打开 README.md,README 明确按用途分章节,如 Instruction Datasets(指令数据集)等。
cat README.md -
4按任务类型筛选
依据 README 分类浏览:指令微调找 Instruction Datasets 章节,逐条查看规模、来源与许可证标注。
-
5到 Hugging Face 取数据
清单中的数据集托管在外部平台,按条目给出的名称到 Hugging Face 等站点下载使用。
如何确认成功
本地出现 llm-datasets 目录,且 README.md 中能看到 Instruction Datasets 等分类章节,即表示获取成功。
常见问题
Q:这个项目需要安装 Python 依赖或运行服务吗?
A:不需要。README 未给出任何安装或运行命令,它是一份精选数据集与工具的清单型仓库,直接阅读 Markdown 内容即可使用。
Q:克隆仓库后就有数据集文件了吗?
A:没有。仓库只提供索引和说明,真实数据集托管在 Hugging Face 等平台,需按清单条目另行下载。
Q:怎么判断一个数据集是否值得用?
A:README 提出三条标准:准确性(事实正确、可验证)、多样性(覆盖多种用例)、复杂性(多轮、多语言、含推理步骤)。
注意事项
- README 中未提供安装、部署或运行命令,本教程仅为浏览清单的通用准备步骤。
- 使用各数据集前请自行核对其许可证与使用条款。
- README 建议结合人工审核、规则过滤以及评判模型或奖励模型打分来保障数据质量。
核心亮点
- 覆盖指令微调、偏好对齐等后训练全流程,分类清晰,检索高效
- 每个数据集附有规模、许可证等关键信息,便于合规筛选
- 持续更新,社区贡献活跃,紧跟最新开源资源
不足之处
- 依赖社区维护,部分条目可能滞后或缺失
- 文档/社区待观察
适用场景
- 构建领域专属模型时挑选合适的微调数据集
- 对比不同偏好对齐数据集以优化RLHF流程
- 寻找数据清洗工具以提升训练数据质量
替代项目
huggingface/datasets、lm-evaluation-harness、awesome-chatgpt-prompts
上一篇:argilla
下一篇:jailbreak_llms
同类项目推荐
 awesome-japanese-nlp-resources
开源
一份清单搞定日语 NLP 工具、模型与语料检索
A curated list of resources for Japanese natural language processing (NLP): Python l···
 AutoMathText
开源
自动筛选高质量数学语料,提升大模型数学能力
[ACL 2025 Findings] Autonomous Data Selection with Zero-shot Generative Classifiers ···
 plurel
开源
一键生成逼真表格与关系数据,保护隐私加速开发
A synthetic tabular and relational data generation framework
 X-AnyLabeling
开源
一站式AI辅助标注,图像视频文本通吃,导出格式随心配
X-AnyLabeling: A lightweight, efficient, and unified cross-platform desktop applicat···
 anylabeling
开源
点一下就让 YOLO/SAM 自动标好图,人工只做微调
Effortless AI-assisted data labeling with AI support from YOLO, Segment Anything (SA···
 awesome-gee-community-datasets
开源
找 GEE 社区数据集,一个目录直接加载
Community Datasets added by users and made available for use at large
 DataDesigner
开源
从零或种子数据一键生成高质量合成数据,加速 AI 训练
NeMo Data Designer: Generate high-quality synthetic data from scratch or from seed d···
 SocialED
开源
用统一接口跑通社交事件检测,快速复现对比模型
A python library for social event detection
 Awesome-Token-Merge-for-MLLMs
开源
一页看懂多模态Token压缩前沿论文,快速定位技术方案
A paper list about Token Merge, Reduce, Resample, Drop for MLLMs.