

项目预览
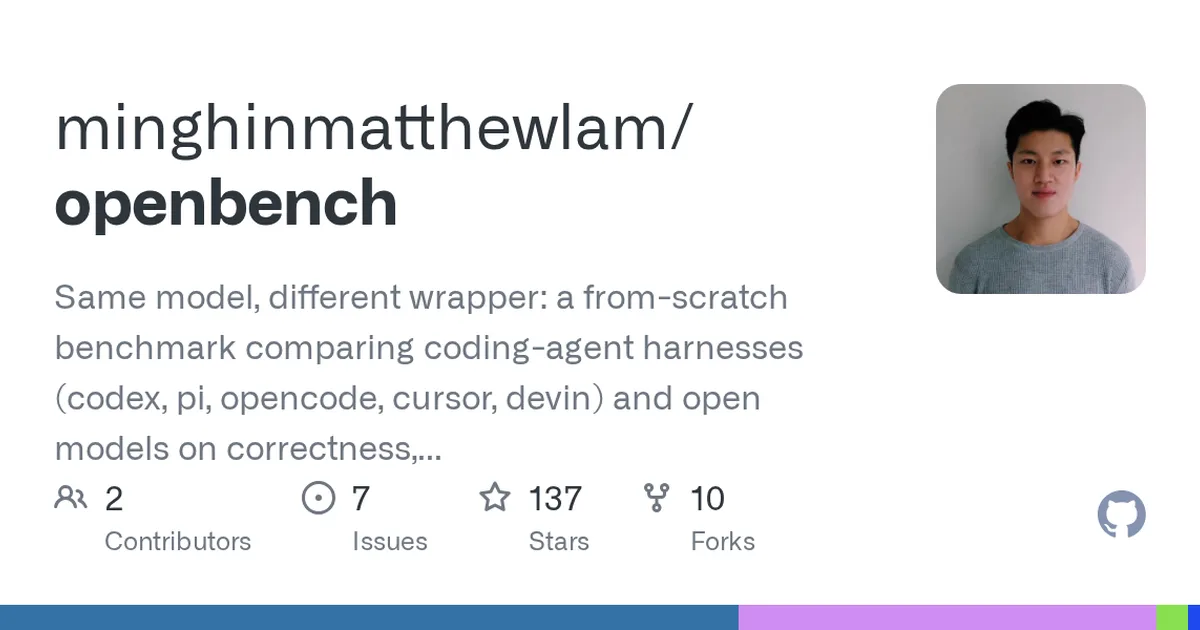
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-08-10 · 当前星标 ★ 137
核心亮点
- 从零构建,不依赖现有评测库,测试逻辑透明可控
- 统一对比多个主流编码智能体(codex、cursor、devin等),选型参考价值高
- 同时评估正确性、速度和Token成本,兼顾质量与经济效益
不足之处
- 项目处于早期阶段,测试任务集覆盖场景可能有限
- 文档和社区生态尚待完善,上手使用需一定技术背景
适用场景
- 企业评估不同编码智能体框架,选择性价比最高的方案
- 开发者对比同一模型在不同工具下的实际表现,优化个人工作流
- 研究机构或评测团队建立编码智能体的标准化评测体系
替代项目
SWE-bench、HumanEval、BigCodeBench
同类项目推荐
 RAGElo
开源
用 Elo 对战排名,快速选出最强 RAG 智能体
RAGElo is a set of tools that helps you selecting the best RAG-based LLM agents by u···
 aws-bench
开源
给AI智能体在真实AWS云上打分的基准测试
aws-bench measures how well AI agents and model combinations perform on real AWS wor···
 evals-skills
开源
跟着课程搭 LLM 评测体系,把主观质量变成可复现指标
Skills for AI Evals to compliment the course: AI Evals For Engineers & PMs
 lm_understand-logs
开源
把神经网络权重当文本,让大模型读懂并生成
Complete logs of the experiments in the blog post 'LLMs can understand and write neu···
 diffusers-interpret
开源
给扩散模型生成图像做“X光”,看清AI为何这么画
Diffusers-Interpret ️♀️: Model explainability for Diffusers. Get explanations ···
 Video-MME
开源
测一测你的多模态模型,视频理解能力到底行不行
✨✨[CVPR 2025] Video-MME: The First-Ever Comprehensive Evaluation Benchmark of Mult···
 AISafetyHot-Hub
开源
每天一份 AI 安全论文清单,md/bib/json 直接喂给 Agent
Safety News & Research Monitor. https://aisafetyhot.com
 Woodpecker
开源
给多模态模型装上纠错器,让AI描述图片不再瞎编。
✨✨Woodpecker: Hallucination Correction for Multimodal Large Language Models
 secure-ai-agent-boundary
开源
给 AI 代理划数据红线,越界访问直接拦住
Secure AI Engineering Framework 2026: Data-Boundary Security for Frontier Models