
项目预览
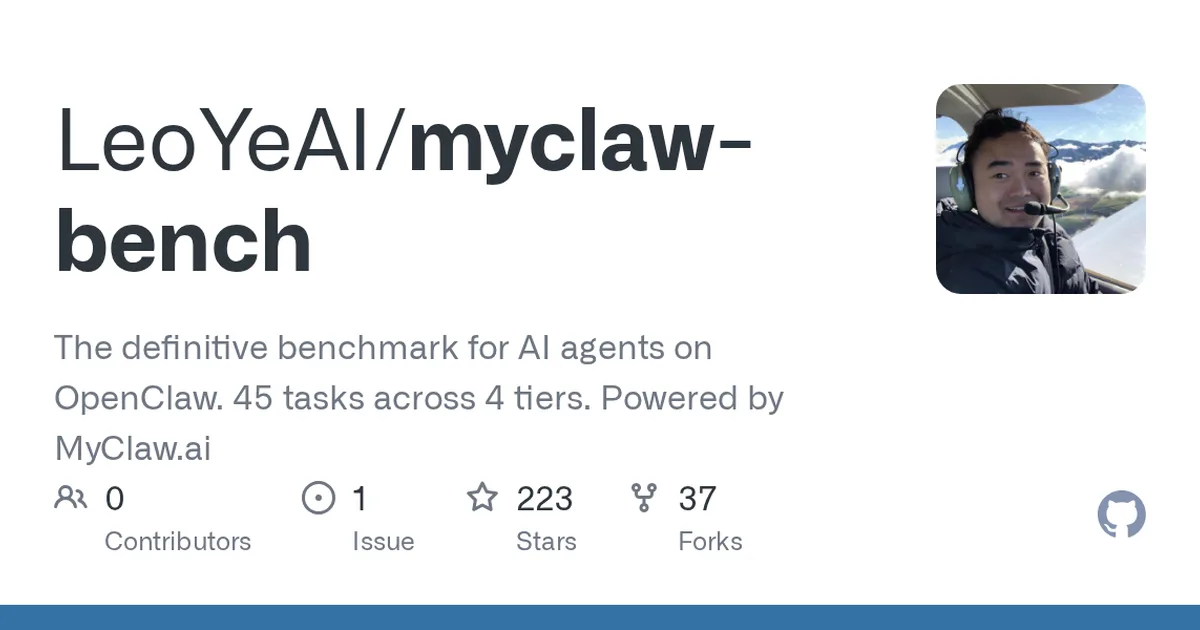
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-08-09 · 当前星标 ★ 222
核心亮点
- 任务分级设计,从简单到复杂覆盖 4 个难度,能细致区分智能体能力差异
- 聚焦 OpenClaw 生态,与 MyClaw.ai 深度集成,测试场景贴合实际应用
- 提供自动化评估流程,减少人工干预,结果可复现,便于版本迭代对比
不足之处
- 仅支持 OpenClaw 智能体,对其他框架的通用性不足
- 文档/社区待观察
适用场景
- OpenClaw 智能体开发者在发布前进行性能验收
- 对比不同版本或配置的智能体能力变化
- 研究机构评估 LLM 在智能体任务中的综合表现
替代项目
AgentBench、GAIA、tau-bench
下一篇:agent-audit
同类项目推荐
 agentjail
开源
给AI编程助手装上安全锁,每次操作先过检再执行
Policy guardrails for coding agents (Claude Code, Codex, Cursor) — every tool call ···
 every_eval_ever
开源
把散落各处的 AI 评测结果统一成可比较的公共数据库
Every Eval Ever is a shared schema and crowdsourced eval database. It defines a stan···
 Auditor
开源
自动化安全审计,快速发现项目漏洞与风险
Release channel for TheAuditor — see blog.theauditortool.com
 ASTRA
开源
实战对抗攻击,一键测出 AI 模型的安全漏洞
Amazon Nova AI Challenge Winner - ASTRA emerged victorious as the top attacking team···
 GLM-5.3-Flash-J-Space-Capability···
开源
把大模型智能体能力评测做成可读报告,一眼看清真实水平
GLM-5.3-Flash × J-Space capability realization — benchmark presentation of the J-S···
 alpaca_eval
开源
自动评估指令跟随模型,快、便宜、且靠谱。
An automatic evaluator for instruction-following language models. Human-validated, h···
 rizzo-pii
开源
本地脱敏文档,再放心喂给 LLM
Local-first privacy guard: anonymize your documents before sharing with LLMs.
 UltraText_Bench
开源
给文生图模型做中英文写字能力体检
[Preprint] UltraText Bench: A Comprehensive Bilingual Benchmark for Evaluating Visua···
 Awesome-MCoT
开源
一张图看懂多模态推理研究脉络与代表工作
Multimodal Chain-of-Thought Reasoning: A Comprehensive Survey