
项目预览
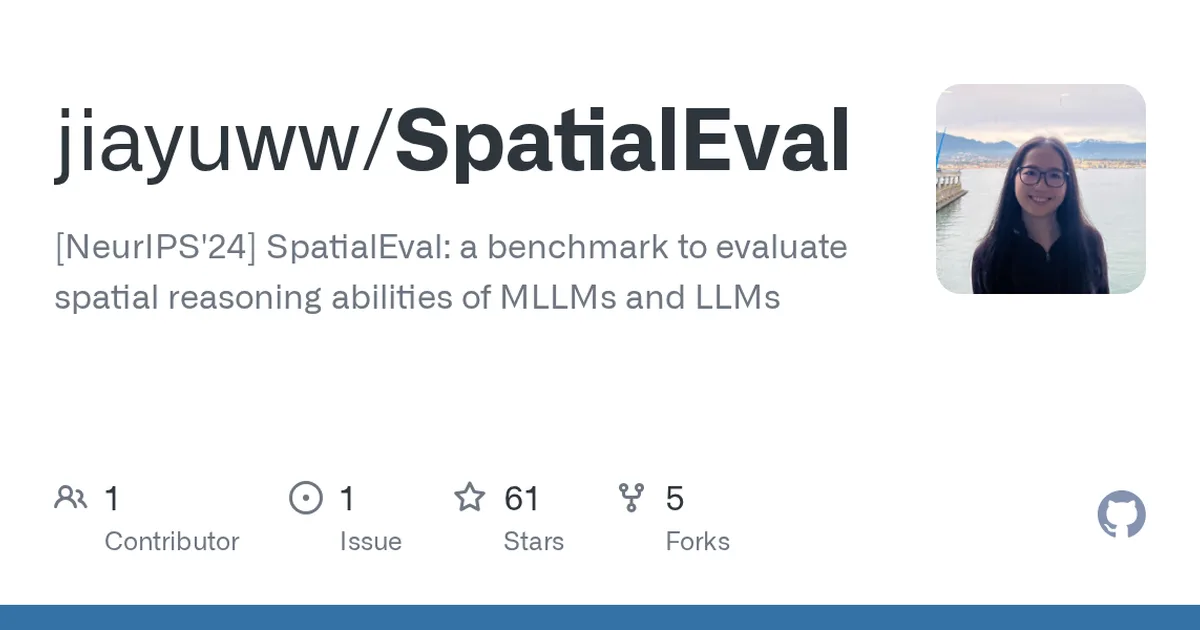
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-08-09 · 当前星标 ★ 62
核心亮点
- 首个系统化覆盖多种空间推理任务的基准,填补评测空白
- 支持多模态和纯语言模型,适用范围广
- 基于 NeurIPS 论文,方法论有学术背书
不足之处
- 项目处于早期,文档和社区支持待观察
适用场景
- 对比不同多模态模型的空间理解能力
- 在模型训练中作为空间推理能力的验证集
- 学术研究中评估模型的空间认知缺陷
替代项目
BLINK、MME、MMBench
上一篇:tensor-trust
下一篇:VLGuard
同类项目推荐
 aws-bench
开源
给AI智能体在真实AWS云上打分的基准测试
aws-bench measures how well AI agents and model combinations perform on real AWS wor···
 benchmark
开源
用200个真实网页任务,跑分对比你的浏览器AI智能体
Open benchmarks for browser agents: BU Bench V2.1, 200 real web tasks. Rerun them wi···
 Guardrails
开源
给大模型对话装上可编程的安全护栏,防止跑偏和有害输出。
NeMo Guardrails is an open-source toolkit for easily adding programmable guardrails ···
 trustmebro
开源
伪造工具输出,测出模型护栏会不会被骗
Bypass llm guardrails by confusing it with fabricated tool output.
 lintlang
开源
上线前扫一遍,AI 智能体配置不踩坑
Static analysis for AI agent configs, tool descriptions, and system prompts — catch···
 TaskMeAnything
开源
自动生成多模态任务,全面评估模型能力
[NeurIPS 2024] A task generation and model evaluation system for multimodal languag···
 Omni-SafetyBench
开源
给音视频大模型做安全体检,发现隐藏风险
[ACM MM 2026] Code for paper "Omni-SafetyBench: A Benchmark for Safety Evaluation of···
 StreamEval
开源
给流式交互视频生成立一把可复现的评测尺
The first-ever interactive streaming video generation benchmark.
 deepchecks
开源
给 ML 模型和数据做全面体检,从研究到生产持续验证
Deepchecks: Tests for Continuous Validation of ML Models & Data. Deepchecks is a hol···