

AudioNotes
上传音视频,自动生成结构化 Markdown 笔记
项目预览
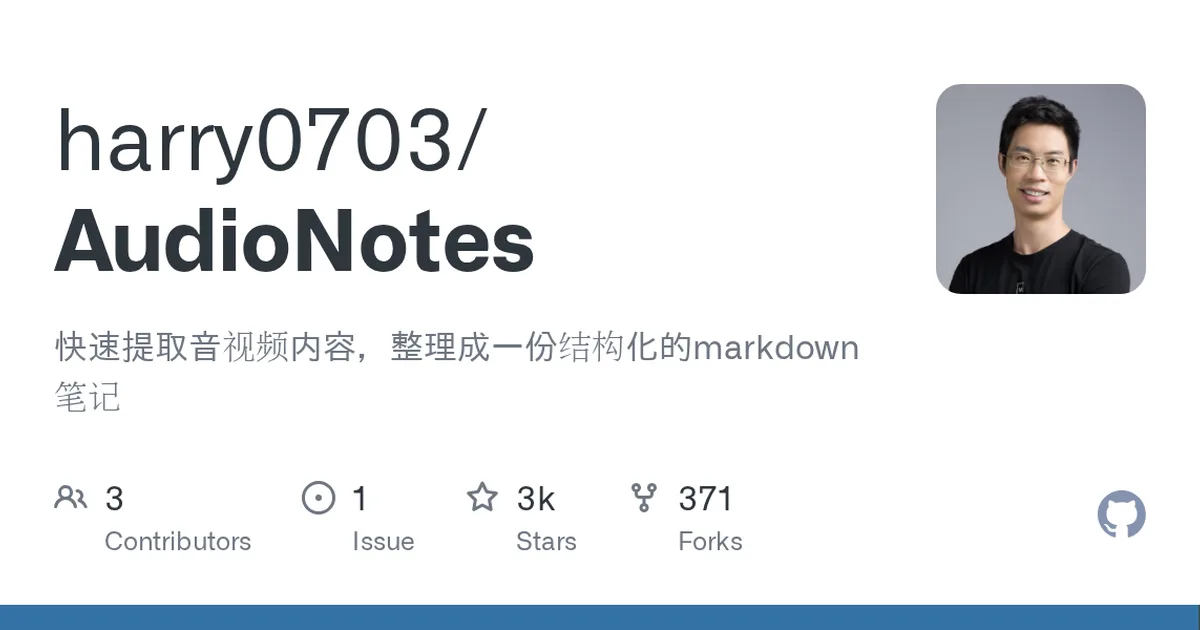
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-08-10 · 当前星标 ★ 2557
使用教程
环境要求
- Docker Desktop(已安装并启动)
- Ollama(已安装并启动)
- Docker Desktop 建议分配至少 12GB 内存,处理长音视频推荐 16GB,并预留约 10GB 磁盘空间
- 源码方式需准备 Python 3.12 和 ffmpeg
- 首次安装需联网下载应用镜像和模型,处理个人内容时不依赖云端 AI 服务
安装与启动步骤
-
1安装并启动依赖
先安装并启动 Docker Desktop 与 Ollama,并给 Docker 分配足够内存和磁盘空间。
-
2拉取本地大模型
用 Ollama 拉取 qwen3.5:2b,后续的笔记整理和内容问答都在本地完成。
ollama pull qwen3.5:2b -
3下载项目配置文件
新建 audionotes 目录,再下载 docker-compose.yml 和 .env 示例配置。
mkdir audionotes cd audionotes curl -fsSL https://github.com/harry0703/AudioNotes/raw/main/docker-compose.yml -o docker-compose.yml curl -fsSL https://github.com/harry0703/AudioNotes/raw/main/.env.example -o .env -
4启动 AudioNotes
在含 docker-compose.yml 的目录下后台启动容器,首次会拉取应用镜像,请耐心等待。
docker compose up -d --remove-orphans -
5打开页面登录
浏览器访问地址,默认账号和密码均为 admin,登录后上传音视频或使用浏览器录音。
-
6源码方式准备
可选方案:克隆代码、建虚拟环境、装依赖、复制 .env,并拉取本地模型。
git clone https://github.com/harry0703/AudioNotes.git cd AudioNotes python3.12 -m venv .venv source .venv/bin/activate python -m pip install -r requirements.txt cp .env.example .env ollama pull qwen3.5:2b -
7源码方式运行
确认 Ollama 已启动后运行 Chainlit 服务,端口同样是 15433。
python -m chainlit run main.py --host 127.0.0.1 --port 15433
如何确认成功
浏览器访问 http://localhost:15433/,用 admin / admin 能成功登录并看到上传页面,即表示启动成功。
常见问题
Q:首次使用为什么很慢?
A:首次识别会自动下载约 2.15GB 的语音模型,等待时间取决于网络速度;模型下载完成后保存在本机,后续无需重复下载。
Q:默认登录账号密码是什么?
A:默认账号和密码均为 admin,登录后可上传音视频或直接使用浏览器录音。
Q:需要联网才能用吗?
A:首次安装需要联网下载应用镜像和模型,之后音视频识别与笔记整理都在本机完成,不依赖云端 AI 服务。
Q:内存不够导致处理失败怎么办?
A:建议给 Docker Desktop 分配至少 12GB 内存,处理较长音视频时推荐 16GB,并预留约 10GB 磁盘空间。
Q:源码方式如何退出环境?
A:在源码目录下执行 deactivate 即可退出 Python 虚拟环境。
注意事项
- Web 页面默认只允许本机访问,不对局域网或互联网开放。
- 音视频、文字稿、笔记和对话历史都保存在本机,请在受信任的电脑上使用并保护本机账户与磁盘数据。
- 需要安装或配置数据库,AudioNotes 会自动创建本地数据文件。
- 源码启动必须确认 Ollama 已启动,否则大模型相关功能不可用。
核心亮点
- 支持 FunASR 和 Whisper 双引擎,识别精度高且可切换
- 集成 Ollama 本地大模型,自动总结要点,无需联网
- 输出标准 Markdown,方便后续编辑和知识管理
不足之处
- 依赖本地 GPU 资源,CPU 环境下转录速度较慢
- 文档和社区支持尚待完善,新手配置可能有一定门槛
适用场景
- 会议录音快速转写并生成纪要
- 网课或讲座视频提炼核心知识点
- 采访或播客内容整理为结构化文稿
替代项目
WhisperX、Faster-Whisper、Vosk
上一篇:Recorder
下一篇:transcribe.cpp
同类项目推荐
 awesome-russian-speech
开源
找俄语语音工具,看这份精选清单就够了
Russian speech technology links
 transcribe
开源
实时转录+AI回复,模拟外语对话练口语
Transcribe is a real time transcription, conversation, Language learning platform. I···
 whisper_android
开源
在安卓手机上离线运行 Whisper,实现即时语音转文字
Offline Speech Recognition with OpenAI Whisper and TensorFlow Lite for Android
 whisper
开源
音频丢进去,多语言文字直接出来
Robust Speech Recognition via Large-Scale Weak Supervision
 WAAS
开源
上传音视频,排队自动转文字,还能调 API
Whisper as a Service (GUI and API with queuing for OpenAI Whisper)
 whisper-auto-transcribe
开源
拖入音频,自动出文字,无需命令行
Auto transcribe tool based on whisper
 TensorFlowASR
开源
用 TF2 快速训练和部署端到端语音识别模型
:zap: TensorFlowASR: Almost State-of-the-art Automatic Speech Recognition in Tensorf···
 hayamimi
开源
纯CPU实时多语言字幕,本地跑不用GPU和云
早耳 - Real-time multilingual speech-to-text on CPU only. Live subtitles, browser da···
 BlahST
开源
在 Linux 任意窗口离线语音输入,并和本地大模型对话。
Input text from speech in any Linux window, the lean, fast and accurate way, using w···