
项目预览
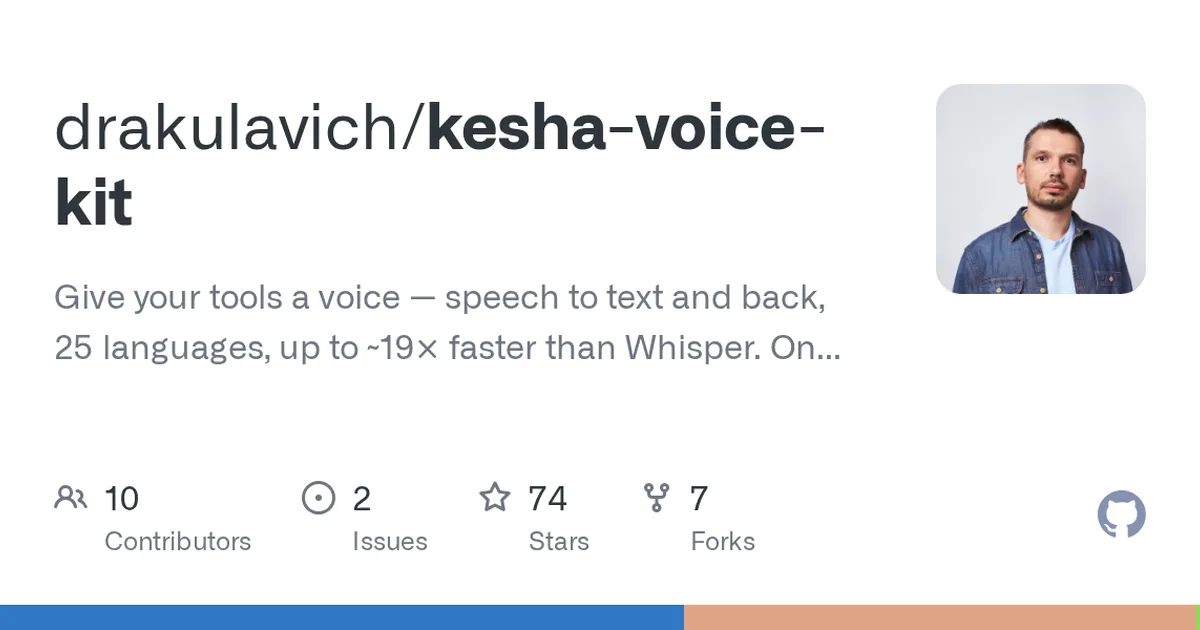
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-08-09 · 当前星标 ★ 80
技术标签
核心亮点
- 基于 CoreML 优化,在 Apple Silicon 上比 Whisper 快约 19 倍,延迟极低
- 支持 25 种语言,离线运行,数据不出本机,隐私安全
- 提供 CLI 和 MCP 接口,可轻松集成到现有开发工具链和智能体
不足之处
- 仅支持 Apple Silicon,Intel Mac 和 Windows/Linux 用户无法使用
- 早期项目,文档和社区生态尚待完善
适用场景
- 本地语音助手开发,实现离线语音指令控制
- 会议或播客的实时转录,快速生成文字记录
- 为智能体(如 OpenClaw)添加语音交互能力
替代项目
Whisper.cpp、Vosk、SpeechRecognition
同类项目推荐
 sonus
开源
Node 里离线监听热词,唤醒后再转文字,不依赖云。
:speech_balloon: /so.nus/ STT (speech to text) for Node with offline hotword detecti···
 vocalinux
开源
在 Linux 上说话就能打字,全程离线不联网
Free, open-source, 100% offline voice dictation for Linux. Speak and type anywhere v···
 opentypeless
开源
按热键说话,任意应用直接出润色文本
Open-source AI voice typing for macOS, Windows, and Linux. Press a hotkey, speak nat···
 pyannote-core
开源
把「时间段+标签」的运算封装好,语音标注不再手写区间逻辑
Advanced data structures for handling temporal segments with attached labels.
 efficientspeech
开源
让语音合成在CPU上也能实时跑起来
PyTorch code implementation of EfficientSpeech - to be presented at ICASSP2023.
 yandex-speechkit-lib-python
开源
几行代码接入 Yandex 语音识别与合成,快速构建语音应用
Python SDK for Yandex Speechkit API.
 whisper
开源
音频丢进去,多语言文字直接出来
Robust Speech Recognition via Large-Scale Weak Supervision
 simple-obs-stt
开源
直播时自动生成实时字幕,直接叠加到 OBS 画面
Speech-to-text and keyboard input captions for OBS.
 Fun-ASR
开源
用大模型听懂中文方言,多语言流式识别一键部署
Fun-ASR speech recognition models, with native Hugging Face Transformers support for···