

项目预览
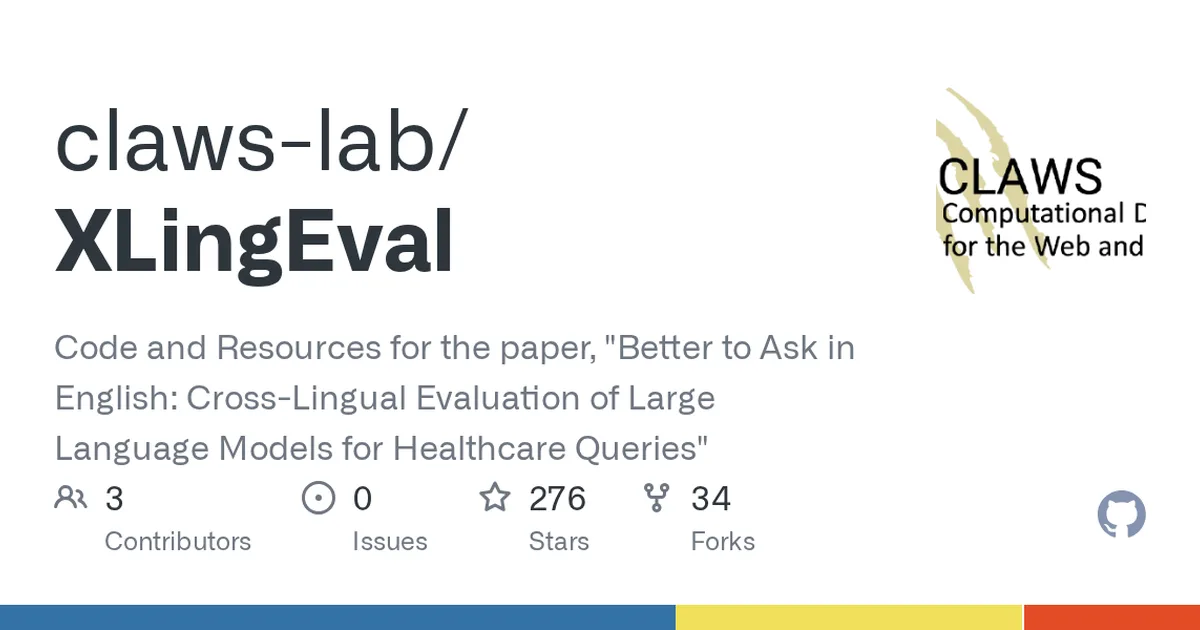
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-08-09 · 当前星标 ★ 409
核心亮点
- 聚焦医疗垂直领域,评估指标贴合医疗场景(如安全性、有用性),而非通用问答
- 提供多语言医疗查询数据集,可直接复现论文实验,降低研究门槛
- 代码基于Python,结构模块化,便于扩展新语言或接入新模型
不足之处
- 文档/社区待观察
- 数据集规模可能有限,覆盖语言和疾病范围待验证
适用场景
- 研究LLM在多语言医疗场景下的性能差异,指导模型优化
- 医疗AI产品上线前,评估不同语言用户的实际体验质量
- 构建多语言医疗问答基准,对比不同模型的跨语言能力
替代项目
MultiMedQA、MMLU (医疗子集)、X-CrossEval
同类项目推荐
 LLM-KG-Bench
开源
一键评测大模型在知识图谱任务上的表现
LLM-KG-Bench is a Framework and task collection for automated benchmarking of Large ···
 auto_LiRPA
开源
给神经网络算严格上下界,验证对抗鲁棒性
auto_LiRPA: An Automatic Linear Relaxation based Perturbation Analysis Library for N···
 Static-to-Dynamic-LLMEval
开源
动态生成评测样本,防数据污染,测出模型真实力
The official GitHub repository of the paper "Recent advances in large language model···
 agent-scan
开源
扫一遍 Agent 和 MCP 配置,提前揪出权限与注入风险
Security scanner for AI agents, MCP servers and agent skills.
 MLLM-Token-Compression
开源
一页看懂多模态大模型Token压缩方案怎么选
Towards Efficient Multimodal Large Language Models: A Survey on Token Compression
 LLMVault
开源
在真实漏洞靶场中练手,掌握 LLM 安全攻防实战
An intentionally vulnerable OWASP LLM Top 10 training platform for AI Security, Prom···
 VBench
开源
给视频生成模型打分,16个维度看清谁强谁弱
[CVPR2024 Highlight] VBench - We Evaluate Video Generation
 Awesome-Mental-Health-LLMs
开源
一篇文章看懂LLM做心理健康的技术地图与风险
From Pattern Recognizers to Personalized Companions: A Survey of Large Language Mode···
 FDAbench
开源
给数据智能体打分,看谁更会分析异构数据
[KDD’26] Official repository for the paper “FDABench: A Benchmark for Data Agents ···