

项目预览
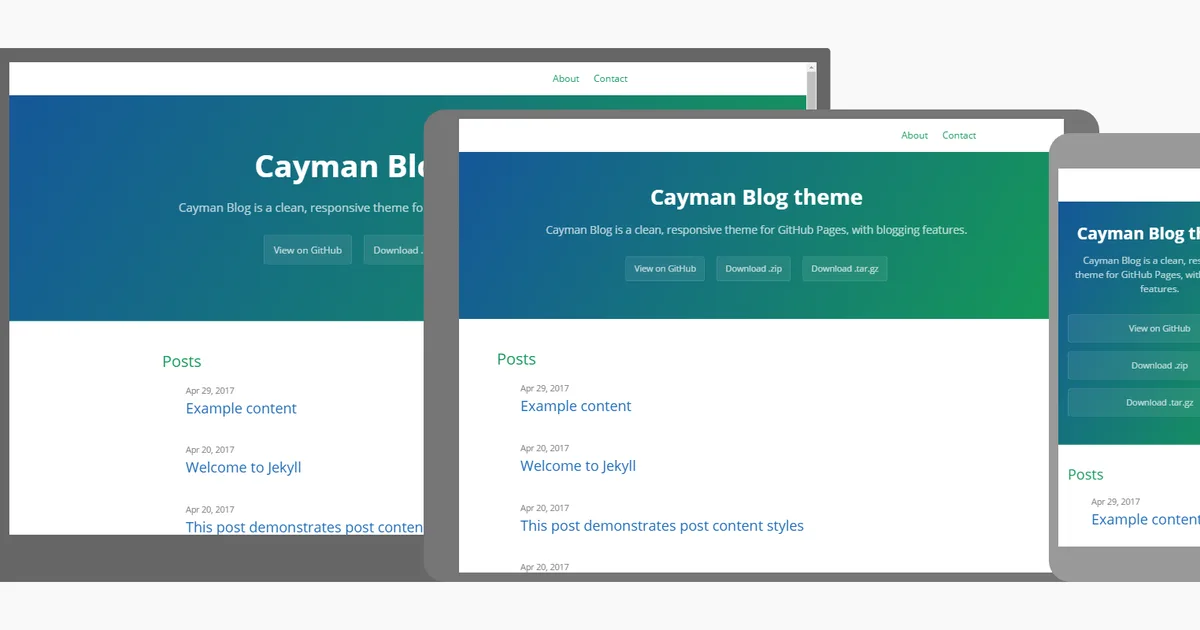
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-08-09 · 当前星标 ★ 127
核心亮点
- 官方论文实现,代码与论文对应,便于复现实验结果
- 支持自定义主题输入,生成音乐与主题契合度高
- 提供预训练模型和示例,上手门槛低,快速体验生成效果
不足之处
- 项目处于早期阶段,文档和社区支持相对有限
- 生成音乐的质量和多样性可能受限于训练数据规模
适用场景
- 音乐创作者快速生成灵感草稿或背景音乐
- AI 音乐生成研究中的基线模型对比
- 教育场景中演示主题条件生成技术
替代项目
MusicTransformer、MuseNet、Magenta
同类项目推荐
 voices
开源
在 macOS 终端一键切换 TTS 语音,还能多语音朗读文本
macOS CLI for changing the default TTS (text-to-speech) voice and printing informati···
 KittenTTS
开源
纯 CPU 就能跑的轻量开源语音合成模型
Open-source State-of-the-art TTS model which runs on a CPU
 AdaSpeech
开源
用少量样本快速定制专属语音合成模型
AdaSpeech: Adaptive Text to Speech for Custom Voice
 hifi-gan
开源
让语音合成又快又真,实时生成高保真音频
HiFi-GAN: Generative Adversarial Networks for Efficient and High Fidelity Speech Syn···
 ACE-Step-1.5
开源
本地跑文本生成音乐,Mac/AMD/Intel 都能用
The most powerful local music generation model that outperforms almost all commercia···
 facet
开源
用代码实时生成图像和音乐,浏览器即兴创作
Live coding and synthesis with NodeJS and a browser
 Hojo-TTS-Light
开源
小体积语音合成模型,低算力也能跑起来
Hojo-TTS-Light is a lightweight speech generation model series developed by HojoAI, ···
 stable-audio-tools
开源
用文本或音频条件,训练并生成可控音乐音效
Generative models for conditional audio generation
 DiffSinger
开源
用扩散模型精修歌声合成,让非自回归 TTS 音质更自然
PyTorch implementation of DiffSinger: Singing Voice Synthesis via Shallow Diffusion ···