

项目预览
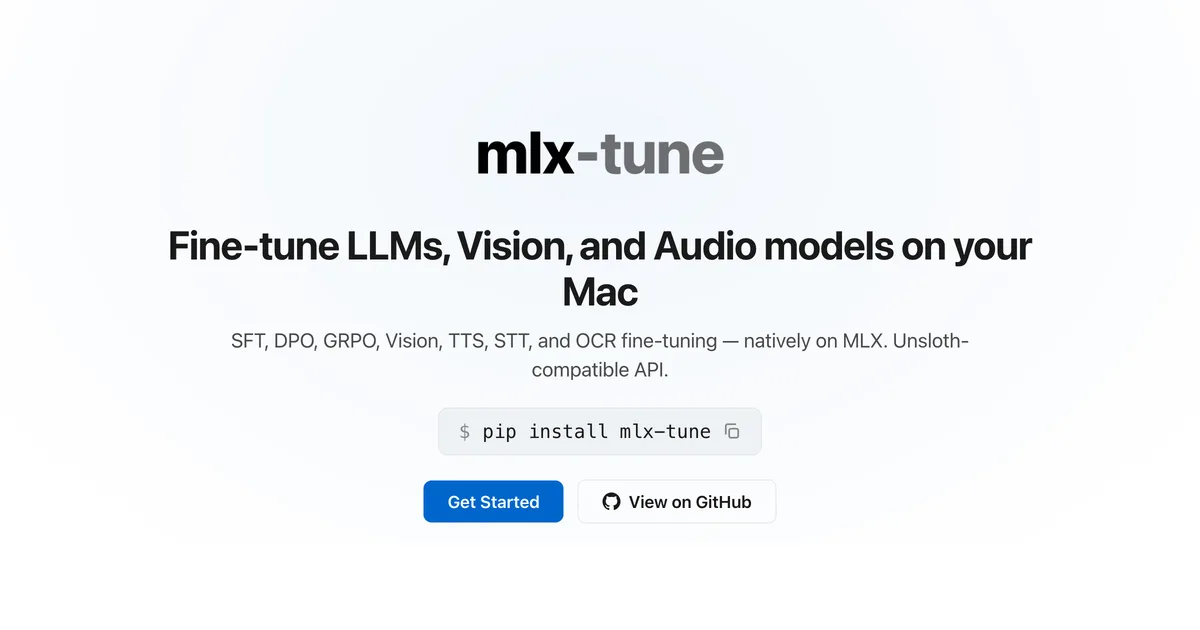
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-08-09 · 当前星标 ★ 1456
使用教程
⚠ 本教程由 AI 依据该项目 README 整理;原始文档不完整,部分步骤为通用流程推断,实际安装请以项目官方文档为准。
⚠ 该项目 README 未提供完整安装说明,以下步骤为通用流程,请以官方文档为准。
环境要求
- Apple Silicon 芯片的 Mac(MLX 原生运行,非 Apple Silicon 不支持)
- Python 3.9 或更高版本
- MLX 0.20 或更高版本
- 可访问 HuggingFace 下载模型(示例使用 mlx-community/Llama-3.2-1B-Instruct-4bit)
安装与启动步骤
-
1检查运行环境
确认本机为 Apple Silicon 且 Python 版本达到 3.9 以上,否则后续无法使用 MLX。
python3 --version -
2安装 mlx-tune
README 的 Installation 段落为空,未给出安装命令;项目通过 PyPI 分发且依赖 MLX 0.20+,请按官网文档安装。
-
3编写快速上手脚本
新建 quickstart.py,粘贴 README 中的 Quick Start 代码:导入 FastLanguageModel 并加载 4bit 模型。
from mlx_tune import FastLanguageModel, SFTTrainer, SFTConfig from datasets import load_dataset model, tokenizer = FastLanguageModel.from_pretrained( model_name="mlx-community/Llama-3.2-1B-Instruct-4bit", max_seq_length=2048, load_in_4bit=True, ) -
4运行脚本验证
执行脚本,首次运行会从 HuggingFace 拉取模型权重;能正常导入 mlx_tune 并加载模型即说明环境可用。
python3 quickstart.py
关键配置
| 配置项 | 必填 | 说明 | 示例 |
|---|---|---|---|
model_name | 是 | 指定要加载的 HuggingFace 模型,可换成任意兼容模型 | mlx-community/Llama-3.2-1B-Instruct-4bit |
max_seq_length | 是 | 最大序列长度,示例中设为 2048 | 2048 |
load_in_4bit | 是 | 是否以 4bit 量化加载模型,降低内存占用 | True |
如何确认成功
脚本运行无报错,mlx_tune 与所需类能成功导入,并完成指定模型的加载。
常见问题
Q:为什么找不到安装命令?
A:README 的 Installation 段落为空,未列出 pip 命令;请以官方文档 https://arahim3.github.io/mlx-tune/ 的最新安装说明为准。
Q:Intel Mac 或 Windows 能用吗?
A:不能。mlx-tune 基于 MLX 框架原生运行,仅支持 Apple Silicon 的 Mac。
Q:必须联网吗?
A:是。示例会通过 HuggingFace 下载 mlx-community/Llama-3.2-1B-Instruct-4bit 模型权重,首次运行需要网络。
Q:内存吃紧怎么办?
A:示例已使用 load_in_4bit=True 和 1B 级别模型,可继续选用更小的模型或降低 max_seq_length。
注意事项
- README 未提供实际安装命令,安装步骤需参考官网文档
- 需满足 Python 3.9+ 与 MLX 0.20+ 才可运行
- 官方提供与 Unsloth 兼容的 API,便于迁移已有训练脚本
- 支持 SFT、DPO、GRPO 及视觉、TTS、STT、嵌入、OCR 等多种微调任务
核心亮点
- 原生 MLX 优化,充分利用 Apple Silicon 统一内存,训练效率高
- 支持 SFT/DPO/GRPO 及视觉、语音、OCR 等多模态微调,功能全面
- API 兼容 Unsloth,方便从云端方案无缝迁移到本地
不足之处
- 仅支持 Apple Silicon Mac,硬件限制明显
- 文档/社区待观察
适用场景
- 个人开发者在本机快速实验模型微调,无需 GPU 服务器
- 隐私敏感场景下本地训练,避免数据上传云端
- 教育或研究用途,低成本教学 LLM 微调流程
替代项目
Unsloth、Axolotl、LLaMA-Factory
上一篇:OpenSeq2Seq
下一篇:LLaSA_training
同类项目推荐
 diffusion_distiller
开源
把扩散模型蒸馏成少步采样,生成速度提升数倍
PyTorch Implementation of "Progressive Distillation for Fast Sampling of Diffusion M···
 ToolOrchestra
开源
用强化学习训练模型更聪明地调用工具、编排工作流
ToolOrchestra is an end-to-end RL training framework for orchestrating tools and age···
 surogate
开源
用 C++ 和 CUDA 把大模型微调速度拉到极致
Train and serve LLMs at extreme speed and massive throughput.
 LECO
开源
用LoRA轻量擦除扩散模型中的指定概念,不动原模型
Low-rank adaptation for Erasing COncepts from diffusion models.
 VeOmni
开源
声明式配方,把任意模态大模型训练一键扩展到多机多卡
VeOmni: Scaling Any Modality Model Training with Model-Centric Distributed Recipe Zo···
 focal-frequency-loss
开源
频域聚焦损失,让生成图像细节更清晰
[ICCV 2021] Focal Frequency Loss for Image Reconstruction and Synthesis
 FineEnvs
开源
快速搭 LLM 强化学习环境,从定义到训练一条龙
FineEnvs — RL Environments 101: building and scaling RL environments in the age of ···
 aws-mlops-handson
开源
在AWS上快速搭建CTR预测的MLOps全流程
This repository provides a comprehensive ML infrastructure for CTR prediction, focus···
 kohya_ss-docker
开源
在 Linux 上用 Docker 一键跑 kohya_ss,轻松微调 SD 模型
This is the tandem repository to exploit on linux the kohya_ss training webui conver···