

项目预览
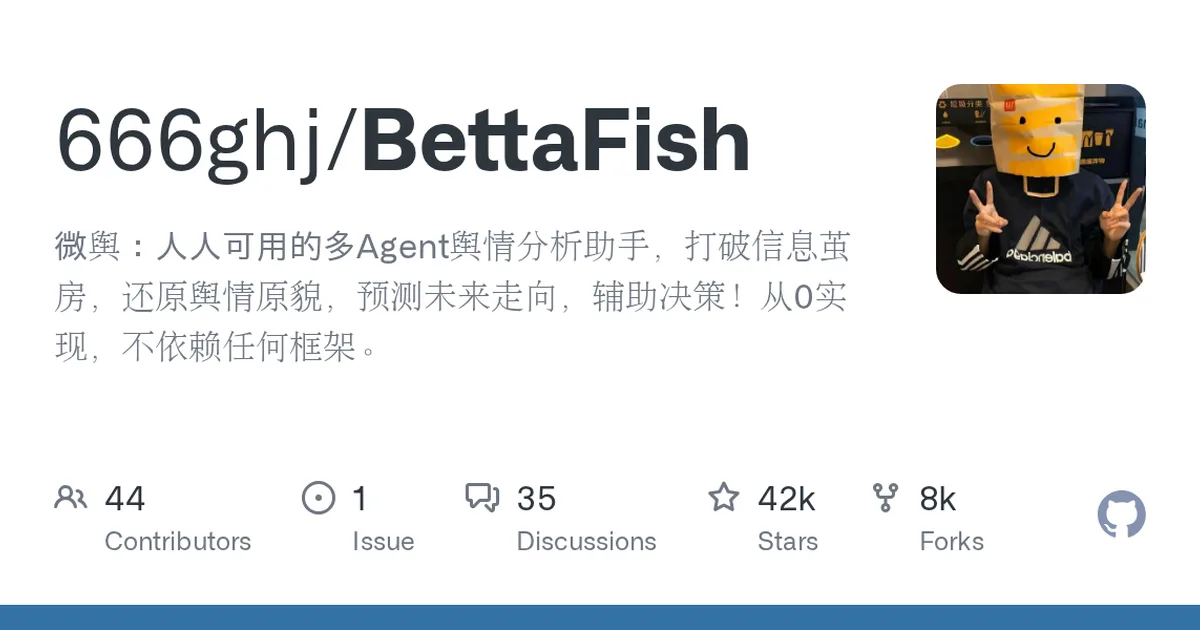
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-08-09 · 当前星标 ★ 42609
使用教程
环境要求
- Python 3 环境(源码方式运行需要)
- Docker 与 Docker Compose(使用 Docker 方式启动时需要)
- PostgreSQL 数据库(也支持自行改为 MySQL)
- 兼容 OpenAI 接口格式的大模型 API 密钥
- PDF 导出可选依赖:weasyprint 所需系统库,不装则 PDF 功能不可用
安装与启动步骤
-
1获取项目源码
把 BettaFish 仓库克隆到本地,之后所有命令都在项目根目录下执行。
git clone https://github.com/666ghj/BettaFish.git -
2准备 Python 环境
README 中 Conda 与 uv 两种方式只给了章节占位,未给出具体创建命令,请按自己习惯创建并激活 Python 环境。
-
3安装依赖包
在项目根目录安装 requirements.txt 中的依赖;README 提示用 uv pip install 安装更快。
pip install -r requirements.txt -
4安装浏览器驱动
爬虫功能依赖 Playwright,需要单独安装 Chromium 驱动。
playwright install chromium -
5配置 .env 文件
复制 .env.example 为 .env,按下方配置项填写数据库连接信息与所有大模型 API 密钥。
cp .env.example .env -
6启动完整系统
在项目根目录启动主应用,一次运行结束后若端口被占用需手动结束占用进程。
python app.py -
7单独启动 Agent
只想调试某个智能体时,可用 streamlit 分别拉起 QueryEngine(8503)、MediaEngine(8502)、InsightEngine(8501)。
streamlit run SingleEngineApp/query_engine_streamlit_app.py --server.port 8503 -
8Docker 一键启动
已装 Docker 的用户复制好 .env 后,用一条命令后台启动全部服务;镜像慢可换用 compose 文件里注释的备用地址。
docker compose up -d
关键配置
| 配置项 | 必填 | 说明 | 示例 |
|---|---|---|---|
DB_HOST | 是 | 数据库服务名称,对应 docker-compose.yml 中的服务名 | db |
DB_PORT | 是 | 数据库端口,PostgreSQL 默认为 5432 | 5432 |
DB_USER | 是 | 数据库用户名 | bettafish |
DB_PASSWORD | 是 | 数据库密码 | bettafish |
DB_NAME | 是 | 数据库名称 | bettafish |
LLM API 密钥 | 是 | 在 .env 中配置各大模型参数,需兼容 OpenAI 接口格式 | sk-xxxxxxxx |
如何确认成功
打开 http://localhost:5000 能看到系统界面即成功;Docker 方式可用 docker compose ps 查看服务。
常见问题
Q:docker compose 拉取镜像很慢怎么办?
A:原 docker-compose.yml 中已通过注释提供备用镜像地址,把镜像地址替换为注释里的备用地址后重新执行 docker compose up -d 即可。
Q:启动后提示端口被占用怎么办?
A:一次运行终止后 streamlit app 可能异常结束但仍占用端口,搜索占用该端口的进程并 kill 掉即可。
Q:不想跑本地情感分析模型行不行?
A:可以。该模型算力需求很小且默认安装 CPU 版,如需跳过,把 requirements.txt 中“机器学习”部分注释掉再执行安装命令。
Q:只想用爬虫系统怎么操作?
A:进入 MindSpider 目录运行:python main.py --broad-topic 提取热点话题与关键词,python main.py --complete --date 2024-01-20 跑完整爬虫流程。
注意事项
- 所有 LLM 调用统一使用 OpenAI 的 API 接口标准,也可换成兼容该格式的其他模型或搜索代理。
- .env.example 和 config.py 中给出了每个 Agent 的推荐 LLM,初次部署请先按推荐设置配置。
- 若跳过 PDF 导出所需系统依赖,weasyprint 可能安装失败,PDF 导出功能将无法正常使用。
- 高级配置已统一到项目根目录的 .env 文件管理,其他子 Agent 会自动继承根目录配置。
核心亮点
- 从零实现,不依赖任何框架,代码透明可定制,适合学习与二次开发
- 多Agent协同工作,覆盖信息采集、分析、预测全流程,自动化程度高
- 提供可视化报告,降低使用门槛,面向非技术用户也能快速上手
不足之处
- 项目较新,文档和社区支持可能不完善,需待观察
- 舆情分析准确性依赖底层LLM能力,可能存在偏差
适用场景
- 企业品牌声誉监测与危机预警
- 政府机构社情民意收集与分析
- 个人用户快速了解热点事件全貌
替代项目
LangChain、AutoGen、MetaGPT
上一篇:jcode
同类项目推荐
 codanna
开源
让 AI 编程助手秒懂你的本地代码库
Local code intelligence MCP server and CLI for AI coding agents
 FindJobs-Agent
开源
用AI智能体搞定简历评分、模拟面试和技能分析,求职更高效
LLM-powered toolkit for skill analysis, AI interviews, resume scoring, and job struc···
 deepseek-harness-studio
开源
零代码桌面端,一键装好 DeepSeek 智能体插件
DeepSeek Harness 零代码桌面端|一键启动,支持 Windows 与 macOS;内置插件发现、热点插···
 synapse-ai
开源
让 AI 代理真正干活,用 DAG 编排多智能体工作流
Build AI agents that actually do things. Synapse is an open-source platform for crea···
 FPF
开源
用第一性原理规范人机协作,让每个决策可审计、可追溯。
FPF (First Principles Framework) Library: methods and pattern languages for open-end···
 riseofmachine
开源
让AI代理帮你挑AI工具,省时省力不踩坑
AI tools curated by autonomous AI agents for makers and SMBs
 lecture-to-hw
开源
把课堂内容一键变成作业提交,省时又统一
A Codex skill that turns course lectures, homework files, classroom code, and previo···
 reverse-engineering-assistant
开源
让 AI 直接操作 Ghidra,逆向分析少翻汇编多出结论
MCP server for reverse engineering tasks in Ghidra
 kangarooking-skills
开源
给 AI Agent 装上一批现成技能,省去重复造轮子
My custom AI Agent skills