
ContextDiff
让AI画图/视频更懂你的文字,语义对齐更精准
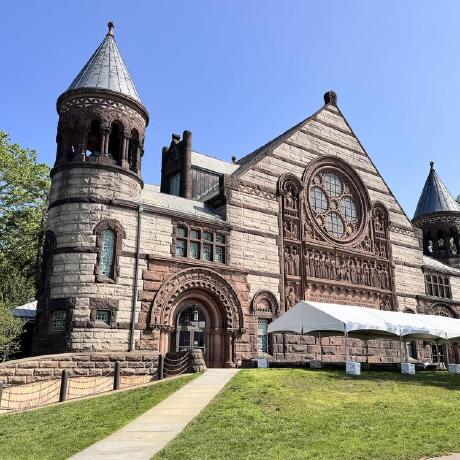
项目预览
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-08-09 · 当前星标 ★ 73
核心亮点
- ICLR 2024 论文背书,方法有学术创新性
- 支持图像和视频双模态生成,覆盖场景广
- 代码开源,可复现论文实验,便于二次开发
不足之处
- 文档/社区待观察
- 项目早期,示例和教程较少,上手门槛较高
适用场景
- 文本生成高精度图像,用于设计稿或插画创作
- 根据文字脚本生成短视频片段,辅助内容创作
- 多模态研究,探索上下文感知的扩散模型改进
替代项目
Stable Diffusion、Imagen、VideoFusion
同类项目推荐
 awesome-claude-fable-5-prompt-va···
开源
一站式掌握 Claude Fable 5 玩法,快速选型不踩坑
Ultimate Claude Fable 5 Guide 2026: Use Cases, Integrations & Benchmarks
 RSP
开源
搞清遥感预训练哪种强,照着跑实验就行
The official repo for [TGRS'22] "An Empirical Study of Remote Sensing Pretraining"
 Diffusion-UI
开源
一个界面玩转多种扩散模型,快速生成动漫风格图像
Anything 4.5, Anything 3.0, Waifu Diffusion, Stable Diffusion 2.1, H Diffusion, Midj···
 Freeze-Omni
开源
冻结LLM,低成本打造低延迟语音对话模型
✨✨Freeze-Omni: A Smart and Low Latency Speech-to-speech Dialogue Model with Frozen···
 decider
开源
一次推理出带概率的类型化决策,省去多轮思考
A family of System One-style models fine-tuned from Qwen3.5, designed for one-pass t···
 Awesome-LLM-Papers-Comprehensive···
开源
一站式找全LLM论文与代码,省去全网搜刮时间
Awesome LLM Papers and repos on very comprehensive topics.
 StartLux-Decision
开源
给每个选项打分,让 AI 决策可量化
Open decision models from 0.8B to 27B: a calibrated probability for every option in ···
 awesome-llm-role-playing-with-pe···
开源
一站式收藏LLM角色扮演资源,快速上手人设对话开发
Awesome-llm-role-playing-with-persona: a curated list of resources for large languag···
 awesome-generative-ai
开源
一榜在手,尽览生成式AI前沿项目与工具
A curated list of modern Generative Artificial Intelligence projects and services