
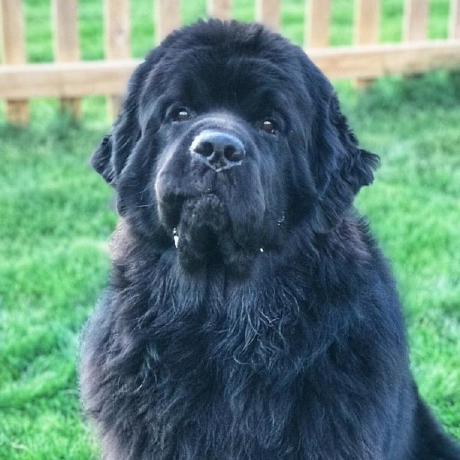
Dreambooth-Stable-Diffusion
用几张照片,微调Stable Diffusion生成专属主体的新图像
项目预览
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-08-09 · 当前星标 ★ 7730
使用教程
⚠ 本教程由 AI 依据该项目 README 整理;原始文档不完整,部分步骤为通用流程推断,实际安装请以项目官方文档为准。
⚠ 该项目 README 未提供完整安装说明,以下步骤为通用流程,请以官方文档为准。
环境要求
- 具备 NVIDIA GPU 且显存充足(README 提到可开启梯度检查点降低显存占用)
- 已安装 PyTorch 与 PyTorch Lightning 相关环境
- 准备好 Stable Diffusion 预训练权重(项目基于 CompVis/stable-diffusion)
- 准备目标主体的参考图像(通常 3~5 张)
安装与启动步骤
-
1克隆项目仓库
从 GitHub 拉取 Dreambooth-Stable-Diffusion 代码到本地,作为后续训练与推理的根目录。
git clone https://github.com/XavierXiao/Dreambooth-Stable-Diffusion.git cd Dreambooth-Stable-Diffusion -
2准备 SD 预训练权重
项目是 Stable Diffusion 上的 Dreambooth 实现,需按其依赖的官方仓库说明准备预训练权重文件。
-
3准备参考图像
收集 3~5 张同一主体(人脸、宠物或物品)的图片,用于把唯一标识符与该主体绑定。
-
4配置运行环境
按 PyTorch 与 PyTorch Lightning 的要求准备依赖;显存不足时可启用梯度检查点技巧。
-
5参照 Usage 运行
README 的 Usage 章节给出实际运行方式,按其中说明执行训练与推理流程。
如何确认成功
README 未提供验证方式;能以 Usage 中的方式启动训练并正常产出模型结果,即视为可用。
常见问题
Q:这个项目和 Textual Inversion 有什么区别?
A:README 说明 Textual Inversion 只优化词嵌入,而 Dreambooth 微调整个扩散模型。
Q:显存不够怎么办?
A:README 9/20 更新的思路是开启梯度检查点(gradient checkpointing)技巧来减少显存占用。
Q:为什么不用原版 Imagen 的 Dreambooth?
A:Imagen 的模型与预训练权重都未公开,因此作者把 Dreambooth 实现在 Stable Diffusion 上。
Q:需要多少张参考图?
A:通常 3~5 张即可完成个性化训练,用于绑定特定主体并生成新场景。
注意事项
- README 节选中没有安装命令与完整用法,本教程步骤为通用准备动作,请以仓库最新说明为准。
- 项目基于 Textual Inversion 代码库,保留了 embedding manager 等实际不会使用的组件,属正常现象。
- 训练需要 Stable Diffusion 预训练权重,README 未给出下载地址,需自行按官方仓库准备。
核心亮点
- 基于官方Dreambooth论文实现,算法原理可靠,训练效果有保障
- 支持少量样本(3-5张)即可完成个性化微调,使用门槛低
- 集成PyTorch Lightning,训练代码模块化,易于扩展和修改
不足之处
- 训练过程对显存要求较高,普通消费级显卡可能难以运行
- 文档以代码注释为主,缺少系统性的使用教程和常见问题解答
适用场景
- 为宠物或家人生成不同场景下的个性化图像
- 产品设计师快速生成特定物品的多种概念图
- 研究者复现Dreambooth算法并在此基础上进行改进
替代项目
Diffusers (Hugging Face)、InvokeAI、Automatic1111/stable-diffusion-webui
上一篇:gorilla
同类项目推荐
 amazon-sagemaker-generativeai
开源
在 SageMaker Studio 里跑通生成式 AI 训练与提示实验
Repository for training and deploying Generative AI models, including text-text, tex···
 reasoning-gym
开源
给AI推理训练提供可验证奖励的现成环境,直接上手RL
[NeurIPS 2025 Spotlight] Reasoning Environments for Reinforcement Learning with Veri···
 LightRFT
开源
用奖励模型驱动微调,让 LLM/VLM 按目标越训越强
LightRFT: Light, Efficient, Omni-modal & Reward-model Driven Reinforcement Fine-Tuni···
 Rethinking-OPD
开源
拆解大模型在线蒸馏为何翻车,给出可复现配方
[TMLR] Rethinking On-Policy Distillation of Large Language Models: Phenomenology, Me···
 EasyEdit
开源
像改数据库一样,直接修改大模型的知识,无需重训练。
[ACL 2024] An Easy-to-use Knowledge Editing Framework for LLMs.
 axolotl
开源
一条命令微调大模型,省心省力
Go ahead and axolotl questions
 DoLa
开源
不重训模型,对比层输出,让大模型少说瞎话。
Official implementation for the paper "DoLa: Decoding by Contrasting Layers Improves···
 EAGLE
开源
让大模型生成速度翻倍,无需牺牲输出质量
Official Implementation of EAGLE-1 (ICML'24), EAGLE-2 (EMNLP'24), and EAGLE-3 (NeurI···
 trainer
开源
在 Kubernetes 上轻松跑起分布式模型训练和微调
Distributed AI Model Training and LLM Fine-Tuning on Kubernetes