

项目预览
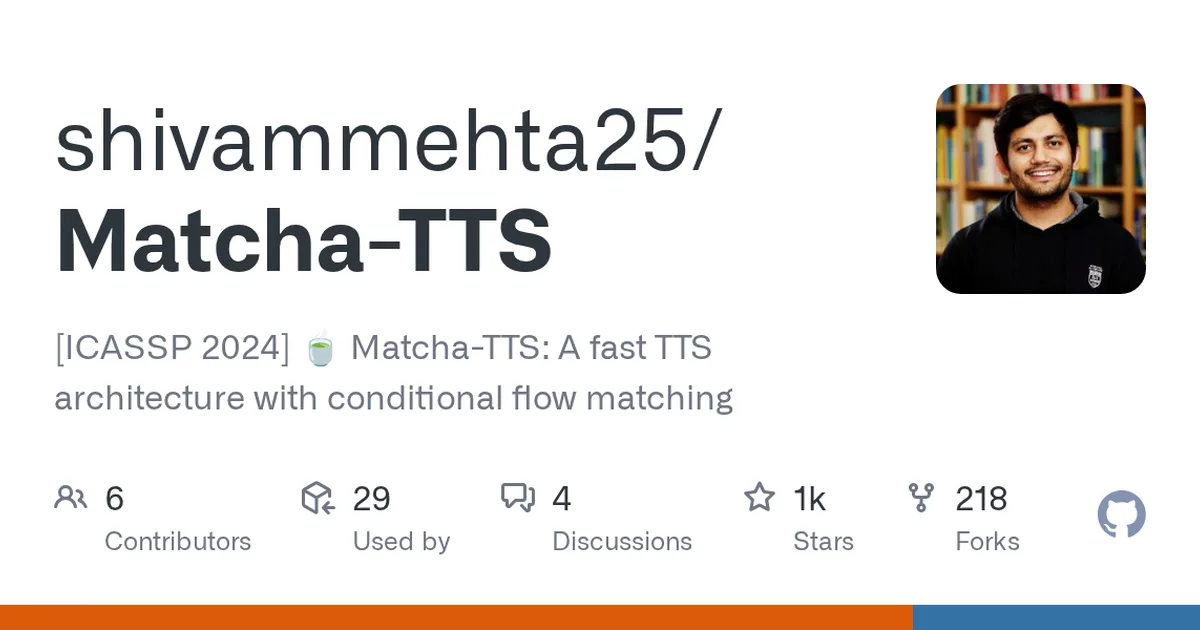
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-08-09 · 当前星标 ★ 1370
使用教程
ℹ 本教程由 AI 依据该项目 README 整理,个别步骤可能需要按你的环境微调。
环境要求
- Python 3.10(README 建议使用该版本)
- pip(用于安装 matcha-tts)
- conda(可选,README 建议用它创建隔离环境)
- 可访问网络的运行环境(预训练模型会自动下载)
安装与启动步骤
-
1创建 conda 环境
README 建议(非必须)先建一个独立环境,指定 Python 3.10,避免与系统环境冲突。
conda create -n matcha-tts python=3.10 -y -
2激活环境
创建完成后激活该环境,后续安装和使用都在此环境中进行。
conda activate matcha-tts -
3pip 安装 Matcha-TTS
最简安装方式,直接从 PyPI 安装 matcha-tts 包,适合只想调用推理功能。
pip install matcha-tts -
4从源码安装
想改代码或本地开发时用这种方式:先装 GitHub 仓库,再进入目录做可编辑安装。
pip install git+https://github.com/shivammehta25/Matcha-TTS.git cd Matcha-TTS pip install -e . -
5运行 CLI/gradio
README 说明可用命令行 CLI、gradio 应用或 Jupyter notebook 三种方式使用,预训练模型会自动下载;具体启动命令请查看仓库最新 README。
如何确认成功
README 未给出明确验证命令;安装过程无报错即基本完成,随后可通过 CLI、gradio 应用或 Jupyter notebook 使用。
常见问题
Q:必须用 conda 创建环境吗?
A:不是必须的。README 写明这一步是建议而非必需,你也可以在已有 Python 3.10 环境中直接用 pip 安装。
Q:pip 安装和从源码安装该选哪个?
A:只想快速使用就选 pip install matcha-tts;需要修改代码、做二次开发则从 GitHub 源码安装并执行 pip install -e .。
Q:预训练模型需要手动下载吗?
A:不需要。README 说明预训练模型会随 CLI 或 gradio 界面自动下载,前提是运行环境能访问网络。
Q:不想本地安装怎么办?
A:README 提供了 HuggingFace Space 在线体验链接,可以直接在浏览器中试用 Matcha-TTS。
注意事项
- conda 环境为可选项,README 标注为 suggested but optional。
- README 节选中第 3 步的运行命令被截断,实际 CLI/gradio 启动命令请以仓库最新 README 为准,不要凭猜测执行。
- 预训练模型通过 Google Drive 链接自动下载,网络受限时可能失败。
- 官方提供了 HuggingFace 在线演示,可用于快速评估效果后再决定是否本地部署。
核心亮点
- 推理速度快,支持一步合成,远超传统自回归模型
- 基于流匹配,训练稳定且音质接近扩散模型
- 提供预训练模型,多说话人支持,开箱即用
不足之处
- 对长文本的韵律控制可能不如自回归模型精细
- 文档/社区待观察
适用场景
- 实时语音助手和交互式对话系统
- 内容创作中的语音生成(如播客、视频配音)
- 低延迟的嵌入式或边缘设备TTS部署
替代项目
VITS、FastSpeech 2、Coqui TTS
下一篇:merlin
同类项目推荐
 LEMAS-TTS
开源
一个模型克隆10种语言的说话人声音,几秒音频即可合成新语音。
LEMAS‑TTS is a multilingual zero‑shot text‑to‑speech system, supporting 10 langu···
 mel-cepstral-distance
开源
算两段语音差多少,客观评估合成质量
A Python library for computing the Mel-Cepstral Distance (Mel-Cepstral Distortion, M···
 serverless-medium-text-to-speech
开源
输入Medium文章链接,一键生成可听的音频版
Serverless-based, text-to-speech service for Medium articles
 parkiet
开源
荷兰语文本秒变自然语音,开源 TTS 模型
Parkiet is a 1.6B parameter Dutch text-to-speech model (TTS)
 text2speech
开源
让印度十亿用户用上母语语音合成
Towards Building Text-To-Speech Systems for the Next Billion Users - Microsoft Resea···
 Fun-Audio-Chat
开源
直接听你说、开口回你,低延迟语音对话模型
Fun-Audio-Chat is a Large Audio Language Model built for natural, low-latency voice ···
 asmr-dubber
开源
音声作品一键识别翻译配音,产出双语字幕和双语音轨
日语/英语/中文音视频 → 中文/英文配音与字幕。支持音色克隆、双语混音、RTF 空间处理、···
 reader
开源
手机拍报纸,秒变电子版,随时读报不费力
毕业设计-基于智能手机的报纸阅读器
 WavTTS
开源
跳过频谱直接建模波形,少量参考音频即可克隆音色
WavTTS: Towards High-Quality Zero-Shot TTS via Direct Raw Waveform Modeling