

项目预览
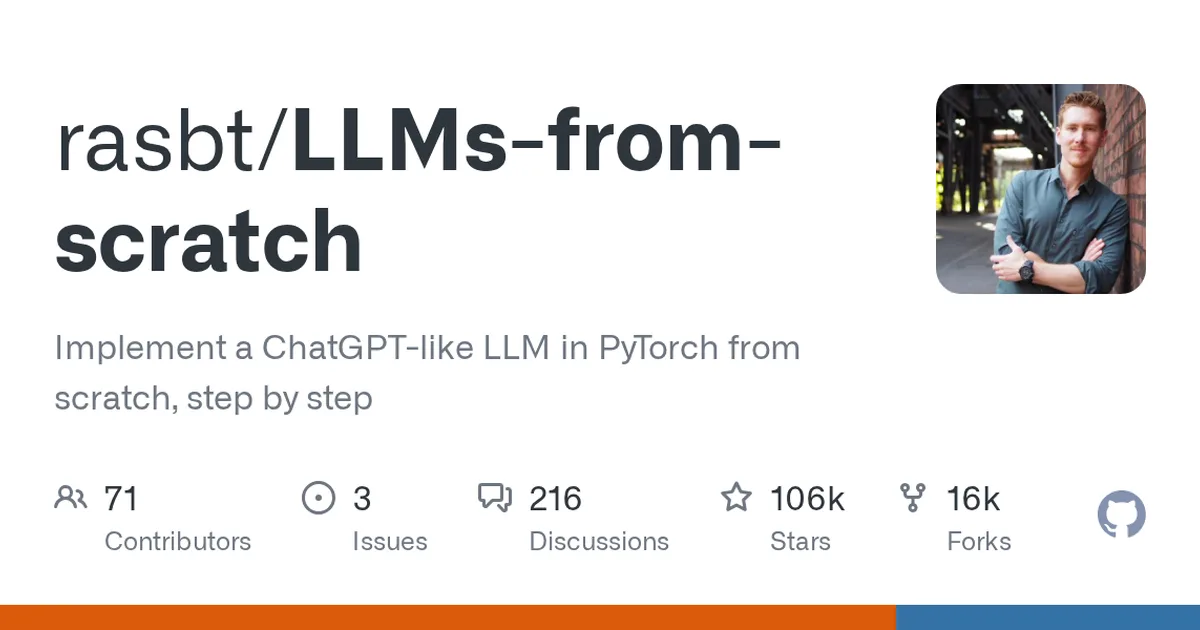
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-08-09 · 当前星标 ★ 107988
使用教程
⚠ 本教程由 AI 依据该项目 README 整理;原始文档不完整,部分步骤为通用流程推断,实际安装请以项目官方文档为准。
⚠ 该项目 README 未提供完整安装说明,以下步骤为通用流程,请以官方文档为准。
环境要求
- 已安装 Git,用于克隆代码仓库
- 已安装 Python 与 Jupyter Notebook / JupyterLab 运行环境
- 能正常访问 GitHub 的网络环境
- 建议配合官方书籍《Build a Large Language Model (From Scratch)》阅读代码
安装与启动步骤
-
1克隆代码仓库
README 给出的官方源码仓库地址,克隆到本地任意目录即可,仓库为书籍配套代码。
git clone https://github.com/rasbt/LLMs-from-scratch.git -
2进入项目目录
切换到刚克隆下来的仓库根目录,后续所有操作都在此目录内进行。
cd LLMs-from-scratch -
3创建虚拟环境
README 未给出具体依赖清单,先建独立 Python 虚拟环境,避免污染系统环境。
python -m venv .venv -
4激活虚拟环境
Linux/macOS 用 source 激活;Windows 请改用 .venv\Scripts\activate。
source .venv/bin/activate -
5启动 Jupyter
项目主体是 Jupyter Notebook,启动后在浏览器中按章节打开对应的 .ipynb 文件学习。
jupyter lab
如何确认成功
终端启动 Jupyter 后浏览器自动打开工作台,能列出仓库中的 Notebook 文件即表示环境就绪。
常见问题
Q:这个仓库需要付费吗?
A:仓库本身是公开的官方源码仓库,免费获取;配套书籍《Build a Large Language Model (From Scratch)》需另行购买。
Q:代码在哪里购买配套书籍?
A:README 给出的官方购书链接为 https://amzn.to/4fqvn0D(Amazon),出版商 Manning 页面为 http://mng.bz/orYv。
Q:可以用预训练好的大模型权重吗?
A:可以,README 说明书中包含加载更大规模预训练模型权重以进行微调的代码。
Q:代码是什么形式?
A:项目主体语言为 Jupyter Notebook,按书籍章节组织,逐行讲解 GPT 类 LLM 的构建、预训练与微调。
注意事项
- README 节选未提供依赖安装命令和具体版本要求,实际依赖请以仓库内各章节说明为准,不要照搬网上其他项目的依赖。
- 本项目定位是教学与学习,代码对应书中从零实现 GPT 类模型的各个阶段。
- 官方网站与购书入口:https://amzn.to/4fqvn0D
- 若无法访问 GitHub,可先配置好网络代理再执行克隆命令。
核心亮点
- 从零逐行实现ChatGPT类LLM,覆盖数据预处理、注意力机制、预训练、指令微调等全流程,教学路径清晰
- 配合作者出版的《Build a Large Language Model from Scratch》书籍,代码与章节一一对应,知识点拆解细致
- 项目拥有超过10万星标,社区反馈活跃,Issue讨论和更新频繁,错误修正及时
不足之处
- 定位为教学示例,代码优化和工程化程度不足,不直接适用于生产环境部署
- 依赖作者个人讲解顺序,读者需要投入大量时间跟踪逐步实现,对初学者有一定门槛
- 部分高级主题(如多模态、分布式训练、模型并行)未深入涉及,覆盖面相对有限
适用场景
- 想系统学习大语言模型内部原理的开发者或研究人员
- 作为高校或培训机构深度学习与NLP课程的动手实践教材
- 需要快速搭建可运行的小型GPT类模型以验证研究想法或教学演示
替代项目
karpathy/nanoGPT、karpathy/minGPT、karpathy/LLM101n
上一篇:MirrorFlow
下一篇:LlamaFactory
同类项目推荐
 GEPA-Lite
开源
用遗传算法自动调优提示词,多目标优化提升模型输出质量
A lightweight implementation of the GEPA (Genetic-Pareto) prompt optimization method···
 AwesomeOPD
开源
一站式速览在线策略蒸馏,紧跟LLM前沿
Awesome List for On-Policy Distillation
 TSLANet
开源
轻量级时间序列全能模型,低算力搞定分类、异常检测等任务
[ICML 2024] A novel, efficient lightweight approach combining convolutional operatio···
 Nemotron
开源
一站式获取 Nemotron 模型训练配方与示例,快速上手微调。
Developer Asset Hub for NVIDIA Nemotron — A one-stop resource for training recipes,···
 data-forcing-distillation
开源
少步生成视频,不丢多样性和画质
Data-Forcing Distillation (DFD): restoring diversity and fidelity in few-step video ···
 Soup
开源
一个YAML搞定大模型微调,4GB显卡也能训8B模型
Fine-tune LLMs from one YAML. Layer streaming trains an 8B model on a 4 GB laptop GP···
 verifiers
开源
一套接口搞定 RL 训练环境与评测
Our library for RL environments + evals
 OntoTune
开源
用本体知识给大模型开小灶,让专业回答更靠谱
[Paper][WWW2025] OntoTune: Ontology-Driven Self-training for Aligning Large Language···
 ggufy
开源
一条命令把 safetensors 转成 GGUF,本地跑模型更省事
CLI/GUI tool for efficient and easy safetensors and gguf model conversion