

项目预览
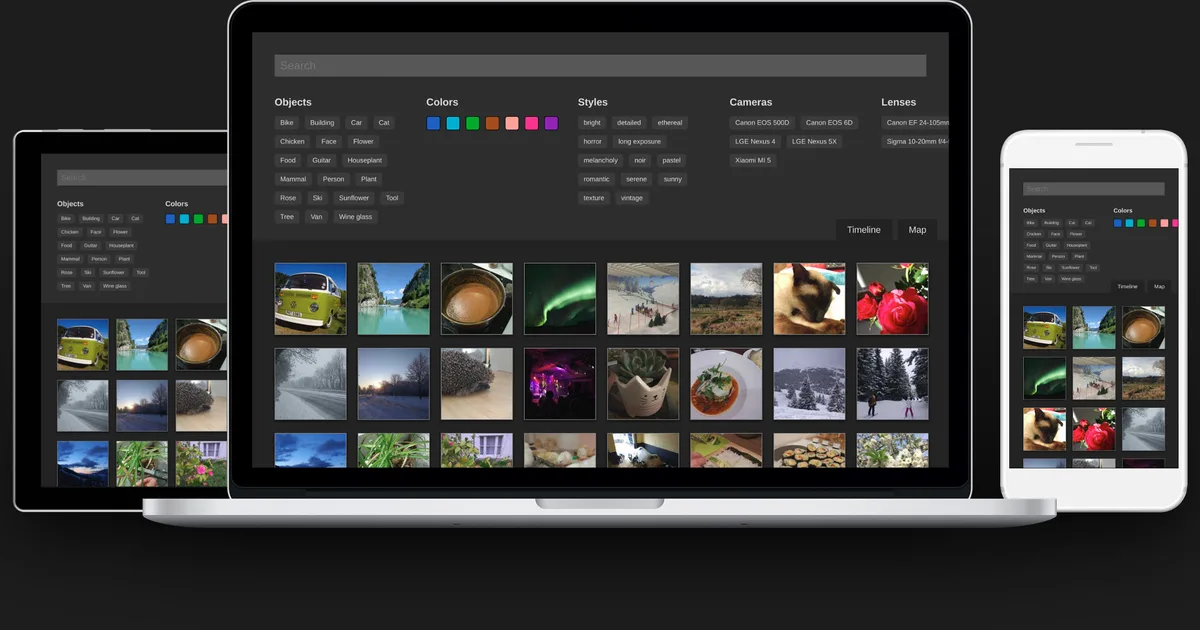
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-08-10 · 当前星标 ★ 1955
使用教程
环境要求
- 已安装 Docker 与 Docker Compose(README 给出 Compose 安装文档链接)
- 有一个可用于访问 http://localhost:8888/ 的浏览器
- 准备一个用来创建超级用户的用户名和邮箱
- 本机有足够磁盘空间存放照片数据目录
安装与启动步骤
-
1创建运行目录
新建 photonix 目录并进入,作为整套服务的运行位置,后续数据都放在这里。
mkdir photonix cd photonix -
2下载 Compose 文件
从官方仓库拉取示例 docker-compose 文件并重命名为 docker-compose.yml,不要手动改名其他内容。
curl https://raw.githubusercontent.com/photonixapp/photonix/master/docker/docker-compose.example.yml > docker-compose.yml -
3创建照片目录
创建容器外的数据卷目录,照片放在这里可被自动检测导入。
mkdir -p data/photos -
4启动服务
该命令会自动拉取并运行所需 Docker 镜像,首次执行耗时较长,请等待镜像下载完成。
docker-compose up -
5创建管理员账号
另开一个终端窗口执行,把 USERNAME 替换成你自己的用户名,按提示设置密码。
docker-compose run photonix python photonix/manage.py createsuperuser --username USERNAME --email example@example.com -
6创建照片库
同样替换 USERNAME,库名可自定义,例如 My Library,创建后即可开始导入照片。
docker-compose run photonix python photonix/manage.py create_library USERNAME "My Library" -
7导入照片
把照片复制到 data/photos 目录,系统会自动检测并立即导入;之后可在 compose 文件里改挂载路径。
-
8开发模式(可选)
仅在参与开发时使用,会构建镜像、挂载代码并支持热重载;需先克隆仓库再执行 make。
git clone git@github.com:photonixapp/photonix.git
cd photonix
mkdir -p  data/photos
make build
make start
关键配置
| 配置项 | 必填 | 说明 | 示例 |
|---|---|---|---|
docker-compose.yml 中 ./data/photos 卷路径 | 是 | 决定照片来源目录,可改成本地常用照片文件夹 | ./data/photos |
Web 访问地址 localhost:8888 | 是 | 服务启动后浏览器访问的地址 | http://localhost:8888/ |
如何确认成功
启动几秒后浏览器打开 http://localhost:8888/ 能正常进入界面,即表示服务运行成功。
常见问题
Q:提示 5432 端口被占用(bind: address already in use)怎么办?
A:说明本机已有 Postgres 等占用标准端口。编辑 docker/docker-compose.dev.yml,把 '5432:5432' 改成 '5433:5432',Redis 和 Web 端口同理处理。
Q:怎么往图库添加照片?
A:把照片移动到 data/photos 目录,系统会自动检测并即时导入。想换目录就修改 docker-compose.yml 里的 ./data/photos 挂载路径。
Q:如何进入 Bash 或 Python 交互环境?
A:开发模式下执行 make shell 即可进入容器内的 shell 环境。
Q:数据都放在哪里,需要自己备份吗?
A:系统数据库、缩略图和缓存与照片分开存储,不会污染照片目录;README 明确说明需自行负责备份,以防出错。
注意事项
- 项目仍处于开发中,尚未达到 1.0 完整功能,可能存在不可用部分。
- README 明确说明用户需自行负责备份,出现错误时官方不代为恢复。
- 创建用户与照片库目前必须通过命令行完成,暂无网页端注册流程。
- 示例 Compose 文件来自官方仓库 docker/docker-compose.example.yml,请勿随意改动内容以免启动失败。
核心亮点
- 集成多种ML算法(人脸、物体、位置、颜色)实现精准搜索,远超传统按时间/文件夹管理
- 支持Docker快速部署,适合家庭服务器/NAS,数据完全自主可控
- 提供类似Google Photos的现代化Web界面,多设备访问方便
不足之处
- 项目活跃度一般,文档和社区支持有待观察
- ML模型可能对低分辨率或特殊场景照片识别准确率有限
适用场景
- 家庭用户自建私有云相册,替代Google Photos等云服务
- 摄影师或内容创作者管理大量照片素材,快速检索
- 注重隐私的团队或机构内部照片资产管理系统
替代项目
Immich、PhotoPrism、LibrePhotos
上一篇:Open3D-ML
同类项目推荐
 ultralytics-YOLO-DeepSort-ByteTr···
开源
点点鼠标,就能用YOLO加跟踪算法跑视频和摄像头
a GUI application, which uses YOLOs (YOLOv8, YOLO11, YOLOv13) for Object Detection/T···
 vit-pytorch
开源
用纯 Transformer 做图像分类,代码简洁易上手,快速复现 SOTA 效果。
Implementation of Vision Transformer, a simple way to achieve SOTA in vision classif···
 camera.ui
开源
本地跑 AI 监控,摄像头秒变智能 NVR
The modern, local-first platform for professional video surveillance.
 TurboOCR
开源
每秒200+张图,TensorRT加速的OCR服务,开箱即用。
TurboOCR, >200 img/s OmnidocBench. TensorRT FP16, PP-OCRv6, HTTP + gRPC
 001
开源
用代码画图,玩转 WebGL 创意视觉
draw_code.001 — ThreeJS, WebGL & GLSL
 albucore
开源
让图像增强算子跑得更快,训练数据管道不再卡顿
A high-performance image processing library designed to optimize and extend the Albu···
 Exp-CLIP
开源
用LLM知识让CLIP看懂表情,零样本识别更准
[WACV'25 Oral] Enhancing Zero-Shot Facial Expression Recognition by LLM Knowledge Tr···
 VideoGLaMM
开源
让AI看懂视频里每个像素,指哪打哪精准分割
[CVPR 2025 ]A Large Multimodal Model for Pixel-Level Visual Grounding in Videos
 OnnxTR
开源
用 ONNX 跑 docTR OCR,不装 PyTorch 也能识别文档文字
OnnxTR a docTR (Document Text Recognition) library Onnx pipeline wrapper - for seaml···