

项目预览
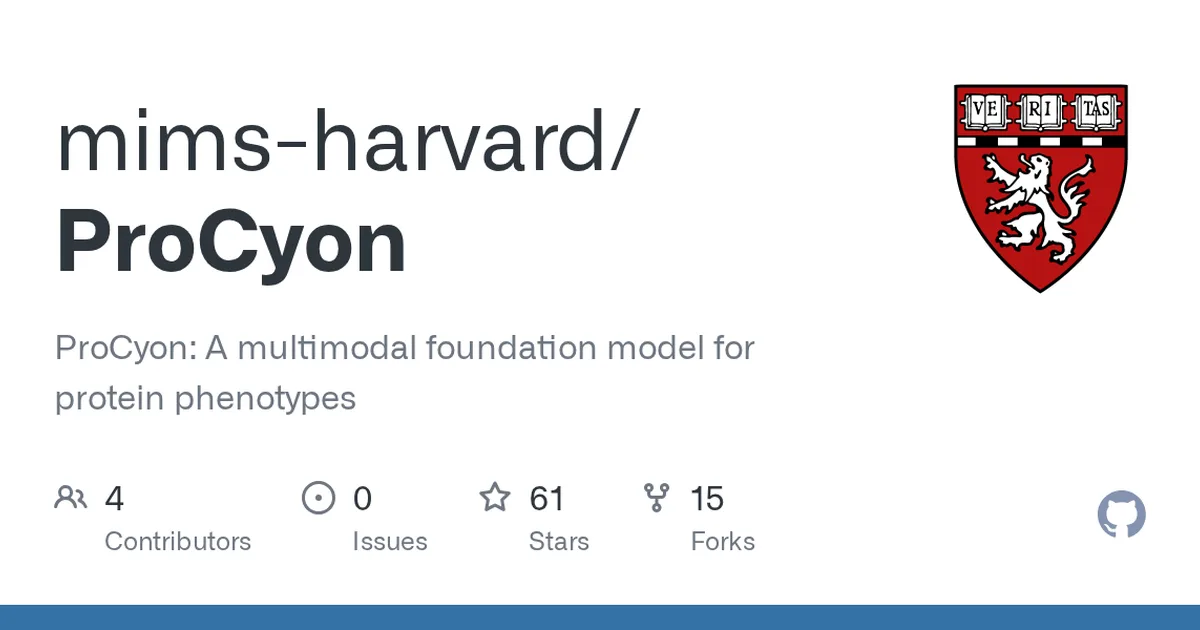
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-08-09 · 当前星标 ★ 62
核心亮点
- 多模态融合设计,同时处理序列、结构、文本,信息利用更全面
- 支持零样本预测,降低对标注数据的依赖,适合新蛋白研究
- 提供可解释性注意力权重,帮助理解预测依据
不足之处
- 文档/社区待观察
- 模型规模与预训练数据细节未充分披露,复现门槛较高
适用场景
- 蛋白质功能注释与未知蛋白快速筛查
- 药物靶点发现中的蛋白-配体相互作用预测
- 突变体表型影响评估
替代项目
ProtTrans、ESM-2、ProteinBERT
上一篇:GFT
同类项目推荐
 Monet
开源
让 Transformer 每个专家只懂一件事,可解释性拉满
[ICLR 2025] Monet: Mixture of Monosemantic Experts for Transformers
 Awesome-Efficient-Reasoning-LLMs
开源
让大模型少想快答,推理效率提升指南
[TMLR 2025] Stop Overthinking: A Survey on Efficient Reasoning for Large Language Mo···
 llama.go
开源
纯 Go 跑 LLaMA,不碰 C++ 也能本地推理
llama.go is like llama.cpp in pure Golang!
 Chinese-Llama-2-7b
开源
下载即用的中文 LLaMA2,让中文对话开箱即跑
开源社区第一个能下载、能运行的中文 LLaMA2 模型!
 Awesome-Foundation-Models-on-Gra···
开源
一站式收藏图基础模型论文、代码和数据集,快速入门研究。
A collection of graph foundation models including papers, codes, and datasets.
 BeyondCLIP
开源
多模态检索实战手册,助你选型不踩坑
Not a neutral survey — a field manual for engineers who build, train, and ship mult···
 Qwen3.8
开源
开源大模型,本地部署即可对话推理写代码
Qwen3.8 is the large language model series developed by Qwen team, Alibaba Group.
 Janus
开源
一个模型搞定看图说话和画图,多模态全能选手
Janus-Series: Unified Multimodal Understanding and Generation Models
 fast-stable-diffusion
开源
一键加速 SD 训练与生成,低配也能玩转 DreamBooth
fast-stable-diffusion + DreamBooth