

项目预览
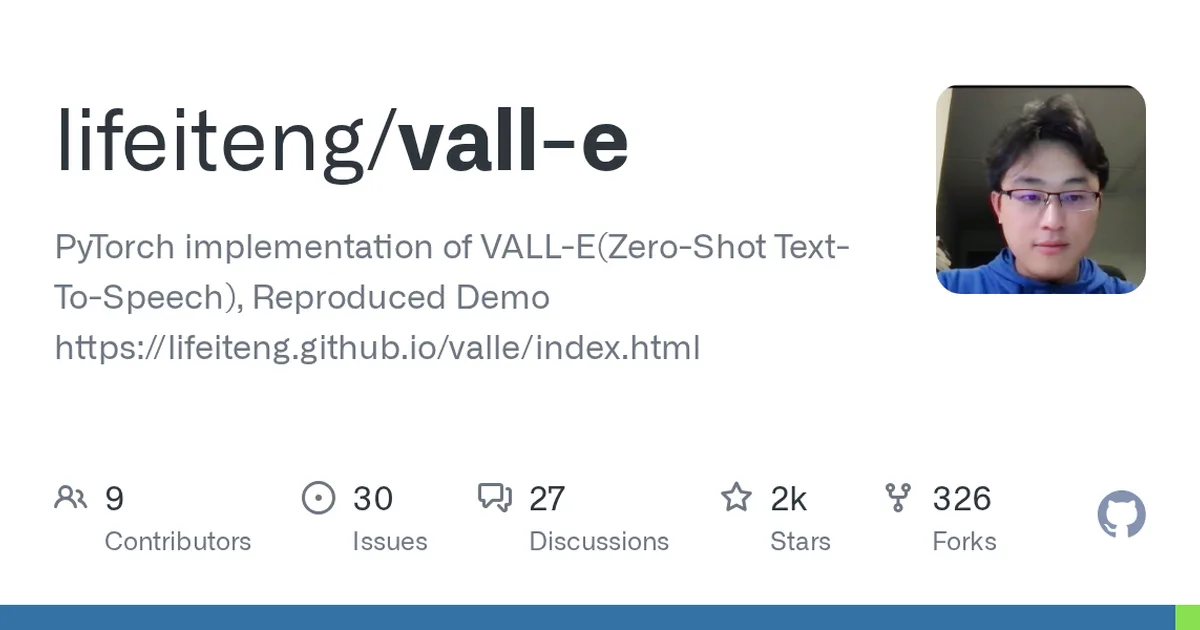
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-08-09 · 当前星标 ★ 2219
使用教程
ℹ 本教程由 AI 依据该项目 README 整理,个别步骤可能需要按你的环境微调。
环境要求
- Python 环境(需安装 pip)
- PyTorch 1.13.1 与 torchaudio 0.13.1(CUDA 11.6 版本)
- espeak-ng(Linux 用 apt-get,macOS 用 brew 安装 espeak)
- 单张 GPU 即可训练(README 说明可在一张 GPU 上训练)
安装与启动步骤
-
1安装 PyTorch
安装 README 指定的 PyTorch 1.13.1 和 torchaudio 0.13.1,使用 CUDA 11.6 的官方源。
pip install torch==1.13.1 torchaudio==0.13.1 --extra-index-url https://download.pytorch.org/whl/cu116 -
2安装 torchmetrics
安装 README 中指定版本的 torchmetrics 0.11.1。
pip install torchmetrics==0.11.1 -
3安装音频处理库
安装 librosa 0.8.1,用于 fbank 特征提取。
pip install librosa==0.8.1 -
4安装 espeak-ng
Linux 系统用 apt-get 安装 espeak-ng;macOS 则改用 brew install espeak。
apt-get install espeak-ng -
5安装 phonemizer 与 pypi
安装 README 指定版本的 phonemizer 和 pypinyin,用于音素与拼音处理。
pip install phonemizer==3.2.1 pypinyin==0.48.0 -
6重装 lhotse
先卸载已有 lhotse,再从官方 GitHub 仓库安装最新版,README 要求更新到新版本。
pip uninstall lhotse
pip uninstall lhotse
pip install git+https://github.com/lhotse-speech/lhotse
如何确认成功
README 未提供启动或验证命令;可通过 python -c "import torch, torchaudio, phonemizer" 检查依赖是否安装成功。
常见问题
Q:为什么 README 说要卸载两次 lhotse?
A:README 原文连续写了两次 pip uninstall lhotse,属于确保彻底卸载旧版再装 GitHub 最新版的写法,照抄执行即可。
Q:macOS 上 espeak-ng 怎么装?
A:README 注明 OSX 使用 brew install espeak,而不是 apt-get install espeak-ng。
Q:没有 GPU 可以跑吗?
A:README 表示可在单张 GPU 上训练 VALL-E,并未提及 CPU 训练方案,建议配备 GPU。
Q:有预训练模型可以下载吗?
A:README 在 Broader impacts 中明确说明不会提供训练好的模型和服务,需自行训练。
注意事项
- 该项目为非官方 PyTorch 实现,训练好的模型和服务不会提供。
- VALL-E 可克隆说话人音色,存在伪造身份等滥用风险,请合规使用。
- README 未给出克隆仓库、训练脚本、推理命令与端口等具体用法,需自行查阅仓库其他文档。
核心亮点
- 零样本语音克隆,仅需3秒音频即可模仿新音色,无需微调
- 基于编解码语言模型,生成语音自然度高,韵律和情感表现佳
- 提供完整训练和推理代码,附带演示页面,便于快速上手
不足之处
- 依赖大规模算力和数据,训练成本较高,资源门槛不低
- 推理速度较慢,自回归生成阶段耗时,实时性不足
- 文档和社区支持相对有限,需自行摸索细节
适用场景
- 有声书和播客制作,快速生成个性化旁白
- 游戏和影视配音,克隆特定角色声音
- 辅助语音交互产品,实现个性化语音助手
替代项目
XTTS (Coqui TTS)、Bark (Suno AI)、Tortoise-TTS
上一篇:VieNeu-TTS
下一篇:IMS-Toucan
同类项目推荐
 MimicMania
开源
输入文本,克隆你的声音,秒出语音
MimicMania is a web application that allows you to generate speech and clone voices ···
 elevenlabs-js
开源
用 Node.js 快速接入 ElevenLabs 高质量 AI 语音合成
The official JavaScript (Node) library for the ElevenLabs API.
 Neural-Voice-Cloning-with-Few-Sa···
开源
用几句话克隆你的声音,快速生成个性化语音
Implementation of Neural Voice Cloning with Few Samples Research Paper by Baidu
 ttslab
开源
本地免费测任意TTS模型,快速对比效果
TTSLab is THE place to easily test ANY text to text to speech model on your own pc w···
 VITS-Pytorch
开源
一键训练端到端语音合成模型,无需复杂对齐
本项目是基于Pytorch的语音合成项目,使用的是VITS,VITS是一种语音合成方法,这种时端到端···
 C-Sharp-Learning-Journey
开源
跟着C#新手项目集,快速上手WinForms和WPF开发。
Some of the projects i made when starting to learn c#, winfroms and wpf
 PL-BERT
开源
用音素级 BERT 让 TTS 说话更自然,韵律更生动。
Phoneme-Level BERT for Enhanced Prosody of Text-to-Speech with Grapheme Predictions
 Matcha-TTS
开源
用流匹配让语音合成又快又自然,一步生成不卡顿
[ICASSP 2024] Matcha-TTS: A fast TTS architecture with conditional flow matching
 Voice-Cloning-App
开源
上传几秒音频,即刻克隆人声并合成任意文本
A Python/Pytorch app for easily synthesising human voices