
voice-dataset-creation 是数据集领域的开源项目,由 hollygrimm 开发,2020 年首次发布。
它收录于数据集分类,该分类目前共有 279 个项目,GitHub 星标数为 72。
项目已超过三个月没有代码更新,维护节奏明显放缓,最近一次代码更新于 2026-09-17。无在线服务,需自行部署,完全免费。
它主要面向的使用场景是:原住民语言数字化存档与教学。同类可对比的替代方案包括 Common Voice、LibriSpeech、VoxPopuli。
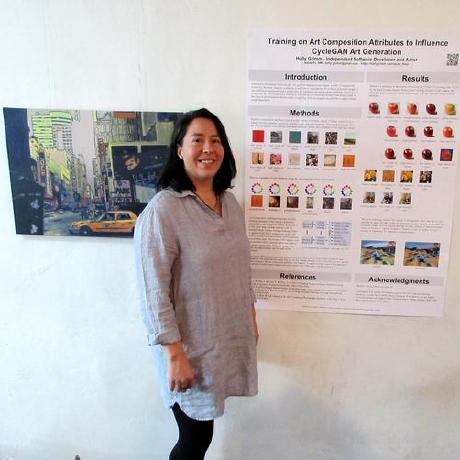
帮原住民社区自主打造语音数据集,守护语言并喂给AI
这是一个面向语言保护与AI开发的社区主导型语音数据集创建工具,旨在帮助原住民社区和语言保护者收集、整理和发布符合数据主权原则的语音数据。项目解决了传统语音数据采集过程中社区参与度低、数据控制权缺失的问题,提供了一套从录音、标注到格式化的完整工作流。核心能力包括:支持Audacity和Adobe Audition等常用音频编辑软件的集成,遵循LJSpeech数据集格式以兼容主流语音识别/合成模型,内置对CARE原则(集体利益、控制权、责任、伦理)的实践指南,确保数据收集过程尊重社区权益。项目还配套了相关学术论文,为原住民文化表达中的AI技术应用提供方法论支持。通过Jupyter Notebook示例,用户可以学习如何构建高质量、合规的语音数据集,促进濒危语言的数字化保存和AI模型训练。
Common Voice、LibriSpeech、VoxPopuli
voice-dataset-creation 是数据集领域的开源项目,由 hollygrimm 开发,2020 年首次发布。
它收录于数据集分类,该分类目前共有 279 个项目,GitHub 星标数为 72。
项目已超过三个月没有代码更新,维护节奏明显放缓,最近一次代码更新于 2026-09-17。无在线服务,需自行部署,完全免费。
它主要面向的使用场景是:原住民语言数字化存档与教学。同类可对比的替代方案包括 Common Voice、LibriSpeech、VoxPopuli。
上一篇:jsut-lab
 X-AnyLabeling
开源
一站式AI辅助标注,图像视频文本通吃,导出格式随心配
X-AnyLabeling: A lightweight, efficient, and unified cross-platform desktop applicat···
 aisheets
开源
像用表格一样批量调 AI,不写代码就能造和改数据集
Build, enrich, and transform datasets using AI models with no code
 distilabel
开源
基于论文的合成数据流水线,快速生成高质量 AI 反馈数据。
Distilabel is a framework for synthetic data and AI feedback for engineers who need ···
 DataGen
开源
用大模型一键生成定制化训练数据,告别数据荒
[ICLR'25] DataGen: Unified Synthetic Dataset Generation via Large Language Models