

项目预览
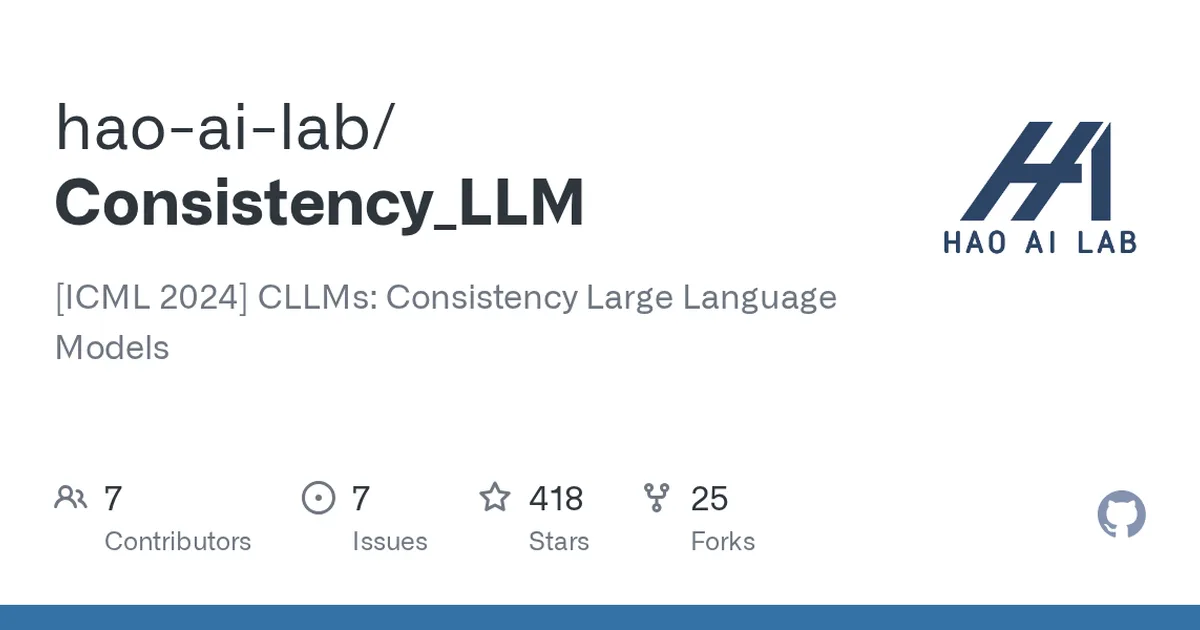
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-08-09 · 当前星标 ★ 418
使用教程
ℹ 本教程由 AI 依据该项目 README 整理,个别步骤可能需要按你的环境微调。
环境要求
- NVIDIA GPU(显存 24GB 起)
- CUDA
安装与启动步骤
-
1建环境
官方指定 Python 3.10。
conda create -n cllm python=3.10 -
2拉仓库
实现并行解码的一致性模型。
git clone https://github.com/hao-ai-lab/Consistency_LLM.git -
3装依赖与权重
微调后的权重需单独获取。
-
4对比延迟
同一提示下比它和原始模型的吐字速度。
-
5看质量损失
加速必然有代价,要量化。
如何确认成功
并行解码下首字后吞吐明显提升,且在标准评测集上的质量下降在可接受范围内
注意事项
- 它让模型一次并行解出多个词,用一致性训练换取速度。
- 加速只在中长输出上明显,短回答看不出差别。
- 需要针对具体基座做微调,换模型要重训。
- 质量下降在需要精确推理的任务上更明显。
- 推理框架支持有限,接入自有服务要改代码。
核心亮点
- 基于 ICML 2024 论文,方法有理论保证,创新性强
- 提供官方代码和预训练模型,易于复现和部署
- 在多个基准任务上验证了 2-4 倍的解码加速效果
不足之处
- 项目早期,文档和社区支持待观察
- 仅支持特定模型架构,泛化性有限
适用场景
- 需要低延迟响应的实时对话系统
- 批量文本生成场景,如摘要、翻译
- 边缘设备上的 LLM 推理加速
替代项目
Medusa、Speculative Decoding、Lookahead Decoding
同类项目推荐
 QuantHarness
开源
一套工具,搞定量化模型标准化评测与对比
Official Repository for QuantHarness
 GFT
开源
用树形词汇表让图模型学会跨数据集迁移,省去重复训练
GFT: Graph Foundation Model with Transferable Tree Vocabulary, NeurIPS 2024.
 LLaVA-MoD
开源
把 LLaVA 模型做小做快,性能不掉线
[ICLR 2025] LLaVA-MoD: Making LLaVA Tiny via MoE-Knowledge Distillation
 KnowLM
开源
给大模型注入知识,让回答更专业准确
An Open-sourced Knowledgable Large Language Model Framework.
 Skywork
开源
开源中英双语大模型,数据权重全开放,快速训练部署
Skywork series models are pre-trained on 3.2TB of high-quality multilingual (mainly ···
 Monet
开源
让 Transformer 每个专家只懂一件事,可解释性拉满
[ICLR 2025] Monet: Mixture of Monosemantic Experts for Transformers
 Awesome-RL-for-LRMs
开源
一份清单,看懂强化学习如何让大模型更会推理
A Survey of Reinforcement Learning for Large Reasoning Models
 RETFound
开源
拿医学影像直接预训练,少标注也能做AI诊断
Vision Foundation Models for Medical AI, including RETFound, DINOv2, DINOv3
 video-SALMONN-2
开源
让AI看懂视频也听懂声音,生成精准音视频描述
video-SALMONN 2 is a powerful audio-visual large language model (LLM) that generates···