

项目预览
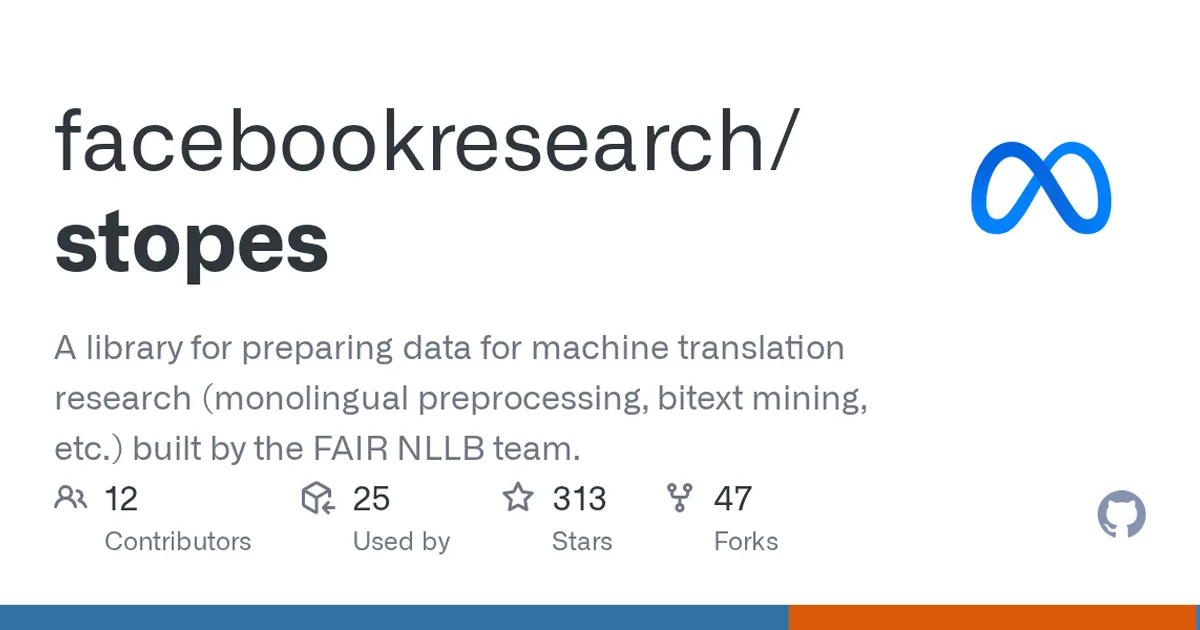
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-08-10 · 当前星标 ★ 315
核心亮点
- 由 Meta FAIR NLLB 团队出品,处理多语言数据经验丰富,代码质量有保障
- 内置 bitext mining 功能,可自动从大规模单语语料中挖掘平行句对
- 模块化流水线设计,支持自定义预处理步骤,适配不同研究需求
不足之处
- 文档/社区待观察
- 项目处于早期阶段,API 可能不稳定,需关注版本更新
适用场景
- 构建低资源语言的机器翻译训练数据集
- 从网络爬取的多语语料中清洗并挖掘平行语料
- 研究多语言翻译模型时的数据增强与平衡
替代项目
LASER、fastText、Moses
同类项目推荐
 GraphGen
开源
用知识图谱自动造微调数据,省人工标注
GraphGen: Enhancing Supervised Fine-Tuning for LLMs with Knowledge-Driven Synthetic ···
 ReadingBank
开源
给 OCR 文字排个正确阅读顺序,训练文档理解模型
ReadingBank: A Benchmark Dataset for Reading Order Detection
 Awesome_Matching_Pretraining_Tra···
开源
一页看尽多模态大模型论文,快速入门不迷路
The Paper List of Large Multi-Modality Model (Perception, Generation, Unification), ···
 lightly-studio
开源
一站式搞定数据清洗、标注与版本管理,让模型训练更快更准。
LightlyStudio - The Unified Data Platform for Multimodal ML
 nepali-datasets
开源
尼泊尔语AI数据一页找齐,省去全网翻找
A comprehensive, curated collection of Nepali datasets aggregated from community sou···
 dataset-viewer
开源
不下载数据集,网页直接看样本和统计
Backend that powers the dataset viewer on Hugging Face dataset pages through a publi···
 prontoqa
开源
用合成问答数据,精准剖析大模型推理链条
Synthetic question-answering dataset to formally analyze the chain-of-thought output···
 rapiddweller-benerator-ce
开源
一键生成、脱敏、迁移测试数据,让开发测试更高效安全。
BENERATOR is a leading software solution to generate, obfuscate, pseudonymize and mi···
 awesome-industrial-datasets
开源
工业AI找数据,一页清单直接定位可用数据集
A curated collection of public industrial datasets.