
项目预览
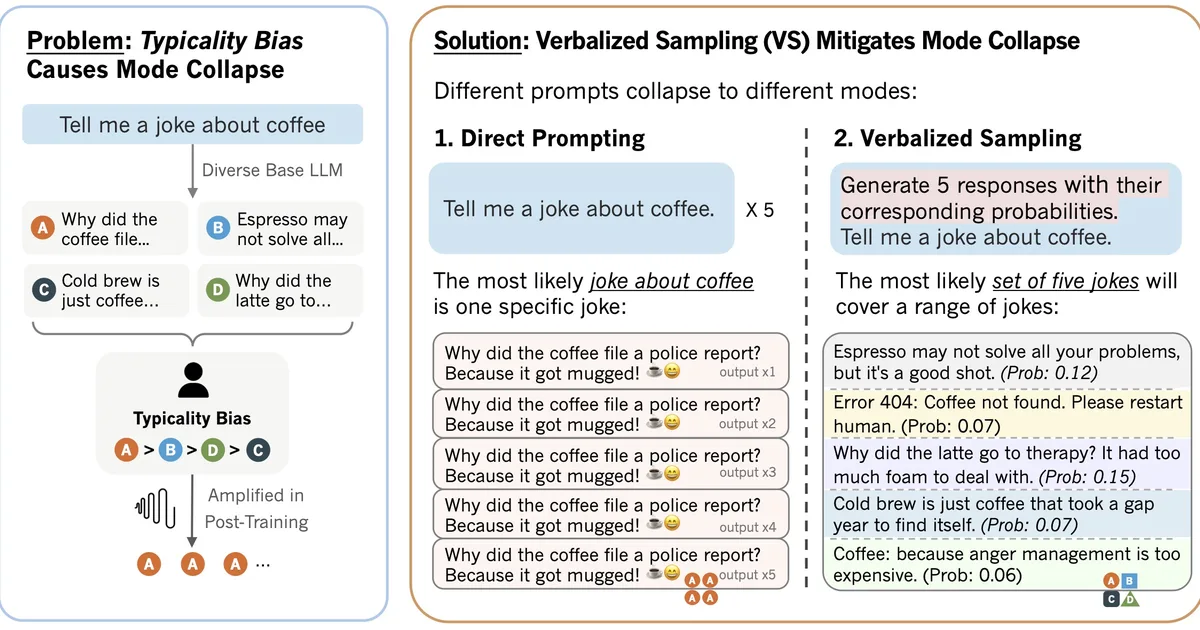
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-08-09 · 当前星标 ★ 823
使用教程
环境要求
- Python 3.9+
- 一个模型 Key
安装与启动步骤
-
1安装
用「先列多种可能再选」提升回答多样性。
pip install verbalized-sampling -
2跑一个任务
对比直接回答与 VS 方法的多样性。
python scripts/tasks/run_poem.py --model gpt-4.1 --methods direct vs_standard --num-responses 50 -
3换任务复验
命名与写故事两类任务各跑一次。
python scripts/tasks/run_state_name.py --model anthropic/claude-sonnet-4 --methods direct vs_standard -
4算指标
用 n-gram 多样性指标量化差异。
python scripts/tasks/run_story.py --model gpt-4.1 --methods direct vs_standard vs_cot --metrics diversity ngram
如何确认成功
VS 方法的输出多样性指标明显高于直接回答。
注意事项
- 它不训练模型,只改提示策略,落地成本低。
- 创意类任务收益大,事实类任务没必要用。
- 也可以直接复制提示词到任意 chatbot 试。
核心亮点
- 无需训练或微调,仅通过提示词工程即可实现,部署成本低
- 多样性提升2-3倍,同时保持生成质量,实测效果显著
- 模型无关,兼容主流LLM,并提供CLI/API方便集成
不足之处
- 依赖模型对概率表达的理解,部分模型可能输出格式不稳定
- 文档/社区待观察
适用场景
- 创意写作:生成多个风格迥异的故事情节或文案
- 合成数据生成:为训练集增加多样性样本,提升模型泛化能力
- 对话模拟:生成多轮对话的多种可能走向,用于测试或角色扮演
替代项目
Top-p (nucleus) sampling、Temperature sampling、Contrastive Search
同类项目推荐
 finetrainers
开源
用有限显存微调视频扩散模型,多卡也能跑
Scalable and memory-optimized training of diffusion models
 Spatial-SSRL
开源
让AI看懂空间关系,无需人工标注,强化学习自动提升空间推理。
[CVPR 2026] Official release of "Spatial-SSRL: Enhancing Spatial Understanding via S···
 Dreambooth-Stable-Diffusion
开源
用几张照片,训练专属 Stable Diffusion 模型,生成你的定制图像。
Implementation of Dreambooth (https://arxiv.org/abs/2208.12242) by way of Textual In···
 CorDA
开源
用上下文感知的低秩分解,让大模型微调更省资源更精准
CorDA: Context-Oriented Decomposition Adaptation of Large Language Models for task-a···
 maji-merger
开源
在 WebUI 里拖拽调参,几秒合并出全新模型
A WebUI extension for model merging
 arkor
开源
用 TypeScript 搞定大模型微调,工程化更顺滑
The Best TypeScript framework for fine-tuning
 Sklearn-genetic-opt
开源
用遗传算法自动调参,告别网格搜索的低效
Hyperparameter optimization and feature selection for scikit-learn using evolutionar···
 foundation-model-stack
开源
按需拼装的 PyTorch 基础模型训练与推理组件库
Collection of components for development, training, tuning, and inference of foundat···
 twinkle
开源
一站式训练工作台,让模型训练更省心
Twinkle✨: Training workbench to make your model glow.