

项目预览
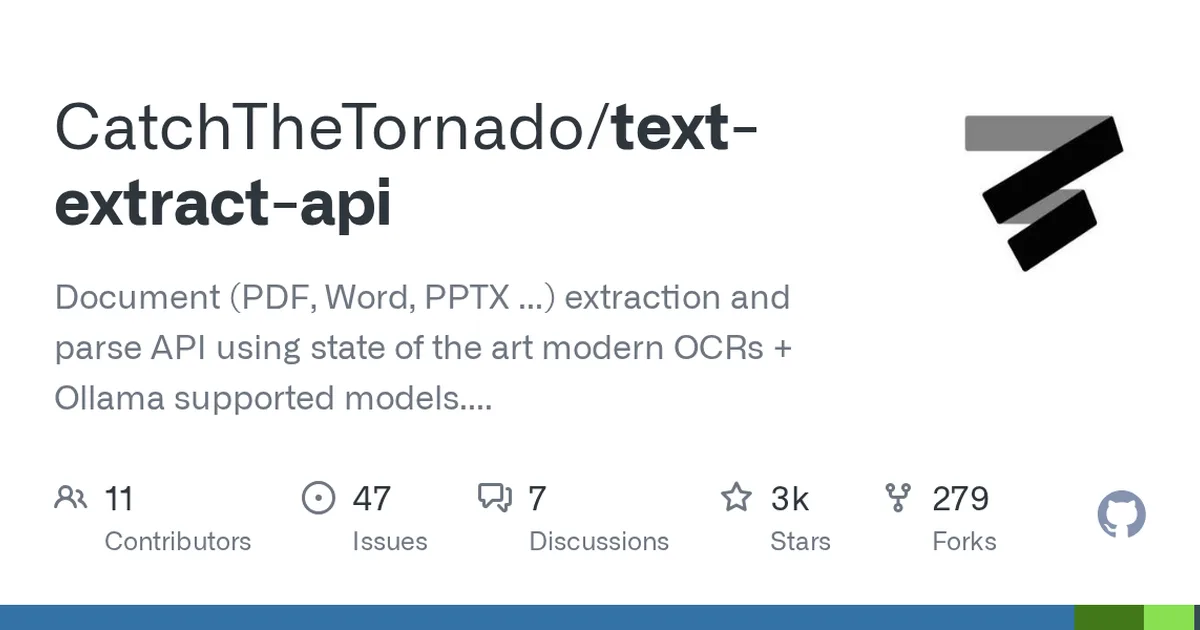
项目数据
项目介绍
Star 增长趋势
本站每日记录该项目 GitHub 星标变化,观测越久曲线越完整
数据来源:GitHub API 逐日快照 · 收录于 2026-08-09 · 当前星标 ★ 3193
使用教程
环境要求
- Docker 与 Docker Compose(用于构建 FastAPI、Celery、Redis、Ollama 服务)
- Python 3(本地源码方式安装时需要,README 使用 python3 -m venv)
- macOS 本地运行需安装 libmagic、poppler、pkg-config、ghostscript、ffmpeg、automake、autoconf
- 磁盘/内存需能容纳 PyTorch 版 EasyOCR 与 Ollama 模型
安装与启动步骤
-
1获取项目代码
克隆仓库到本地并进入项目根目录,后续所有命令都在该目录下执行。
git clone https://github.com/CatchTheTornado/text-extract-api.git cd text-extract-api -
2复制环境变量模板
Docker 部署用 .env.example,本地运行用 .env.example.localhost,默认值一般可直接使用。
cp .env.example .env -
3修改环境变量
按需修改 .env 中的 Redis 地址、存储策略路径和 Ollama 视觉提示词等配置。
-
4Docker 构建并启动
一条命令启动 FastAPI、Celery Worker、Redis 与 Ollama 四个服务,首次构建耗时较长。
docker-compose up --build -
5GPU 模式启动
需要 GPU 加速时改用 gpu 专用 compose 文件,项目前缀设为 text-extract-api-gpu。
docker-compose -f docker-compose.gpu.yml -p text-extract-api-gpu up --build -
6本地源码安装
创建虚拟环境、安装依赖并执行 run.sh;run.sh 会通过 Docker 启动 Redis,因此并非完全脱离 Docker。
python3 -m venv .venv source .venv/bin/activate pip install -e . chmod +x run.sh run.sh -
7安装 macOS 依赖
使用 Homebrew 安装文档解析所需的系统库,仅在 macOS 本地运行时需要。
brew update && brew install libmagic poppler pkg-config ghostscript ffmpeg automake autoconf -
8启动 Celery Worker
macOS 本地运行时需另开终端启动 Celery Worker 处理异步 OCR 任务,--pool=solo 适配 Mac。
source .venv/bin/activate && celery -A text_extract_api.celery_app worker --loglevel=info --pool=solo
关键配置
| 配置项 | 必填 | 说明 | 示例 |
|---|---|---|---|
APP_ENV | 否 | 设为 production 进入生产模式,否则为开发模式并自动重载代码 | production |
REDIS_CACHE_URL | 是 | Redis 缓存地址,用于缓存 OCR 结果 | redis://localhost:6379/1 |
STORAGE_PROFILE_PATH | 否 | 存储策略配置文件所在路径 | ./storage_profiles |
LLAMA_VISION_PROMPT | 否 | 传给视觉模型的 OCR 提示词 | You are OCR. Convert image to markdown. |
service_account_file | 否 | 启用 Google Drive API 时的服务账号授权 JSON 文件路径 | /storage/client_secret_269403342997-290pbjjlb06nbof78sjaj7qr |
folder_id | 否 | Google Drive 中要处理的文件夹 ID | 1AbCdEfGhIjKlMnOpQrStUvWxYz |
如何确认成功
docker-compose 启动后 FastAPI、Celery Worker、Redis、Ollama 四个服务均运行;执行 CLI 的 ocr_upload 命令能返回 OCR 结果即成功。
常见问题
Q:Mac 上能用 Docker 调用 Apple GPU 吗?
A:不能。Docker 目前不支持 Apple GPU,需要按 README 的本地(native)方式运行,并单独启动 Celery Worker。
Q:本地方式完全不需要 Docker 吗?
A:不是。README 明确说明 run.sh 仍会通过 Docker 启动 Redis,所以本地方式并非完全脱离 Docker。
Q:如何避免自动创建 .venv 虚拟环境?
A:在使用 Makefile 时,命令前加 DISABLE_VENV=1,例如 DISABLE_VENV=1 make install 和 DISABLE_VENV=1 make run。
Q:数据会发送到云端吗?
A:不会。README 说明 OCR(EasyOCR)与 Ollama 都通过 docker-compose 本地部署,数据不离开开发机或服务器。
Q:启用 Google Drive 后为什么在网页里看不到文件?
A:服务账号与你的 Google Workspace 账号不同,通过服务账号访问的文件不会显示在普通 UI 中。
注意事项
- Docker 部署与本地部署使用不同的 env 模板:Docker 用 .env.example,本地运行用 .env.example.localhost。
- 使用 Makefile 可自动创建 .venv 虚拟环境,也可用 DISABLE_VENV=1 关闭该行为。
- 首次 docker-compose 构建会下载 PyTorch 版 EasyOCR 与 Ollama 模型,耗时和体积较大。
- CLI 示例:python client/cli.py ocr_upload --file examples/example-mri.pdf --ocr_cache --prompt_file=examples/example-mri-remove-pii.txt
核心亮点
- 支持 PDF、Word、PPTX 及图片,格式覆盖广
- 集成 Ollama 本地模型,数据不出内网,隐私安全
- 内置 PII 匿名化,直接处理合规需求
不足之处
- 依赖外部 OCR 和 Ollama 服务,部署配置稍复杂
- 文档/社区待观察
适用场景
- 企业内部文档数字化与知识库构建
- 自动化处理客户上传的合同、简历等敏感文件
- 批量将扫描件或图片转换为可编辑文本数据
替代项目
Apache Tika、PaddleOCR、Docling
上一篇:sparrow
下一篇:llm_aided_ocr
同类项目推荐
 snow-apps
开源
一站式搞定截图、录屏和OCR,替代系统自带工具
Snow Apps repository, providing source code for Snow Shot and Snow Image Viewer.
 core
开源
把零散 OCR 工具串成标准化流水线,古籍数字化更省心
Collection of OCR-related python tools and wrappers from @OCR-D
 GLAMR
开源
动态相机下,遮挡也能精准重建3D人体
[CVPR 2022 Oral] Official PyTorch Implementation of "GLAMR: Global Occlusion-Aware H···
 STranslate
开源
选中即译、截图即识,Windows 上最顺手的翻译 OCR 小工具
A ready-to-go translation ocr tool developed with WPF/WPF 开发的一款即用即走的翻译、···
 sahi
开源
大图切片推理,小目标检测不漏,精度提升显存降
Framework agnostic sliced/tiled inference + interactive ui + error analysis plots
 vlmrun-cookbook
开源
照着 Notebook 跑通视觉大模型 API,快速做出文档识别原型
Examples and guides for using the VLM Run API
 diffusion-vas
开源
用扩散先验,让视频分割看穿遮挡,补全完整物体。
[CVPR 2025] Official code for Using Diffusion Priors for Video Amodal Segmentation
 Dual-task-Pose-Transformer-Netwo···
开源
上传人物照片和姿态,一键生成自然摆姿的新图像
[CVPR 2022] Exploring Dual-task Correlation for Pose Guided Person Image Generation
 traffic-monitor
开源
摄像头加雷达,边缘端自己算车流和车速
Traffic Monitor built with edge ML for object detection and radar for speed monitori···